

前两天看到了一篇《万字干货!Harness Engineering 如何工程化落地?》的微信长文,讲的是腾讯一个团队如何在真实工程里,用 Rule、Skill、Scripts、多 Agent、Workflow 一步步把 AI「管」起来。文章很长,但难得的不是理念宣讲,而是把踩坑顺序原原本本地交代了。
那阵子我正好集中读了一批同主题的材料,包括对 Vibe Coding 的反思、几篇关于「认知债务」的讨论、社区里的一些翻车实录。读完之后脑子里攒了一团东西,不整理出来不舒服。
先把丑话说在前面:这篇文章里的大部分观点都不是我原创的,它们来自上面这些阅读和讨论。我做的事情只有三件:把它们按自己的理解重新组织;在关键处补上自己的评注——哪里认同,哪里有保留;以及在少数几个位置,放进我自己这阵子在实践里撞出来的疑问。
这篇只谈「道」,即 AI 应用的理论根基。至于「器」与「术」,那篇微信长文讲得比我细致得多,建议直接读原文。
一、Vibe Coding 的幻灭
2024 年开始,科技圈被一个极具诱惑力的词裹挟了——Vibe Coding(氛围编程)。
社交媒体的演示里,产品经理用大白话敲出百十字需求,AI 就能吐出一个带漂亮 UI、鉴权登录和数据库交互的 SaaS 原型。一时间很多人产生了一种错觉:软件工程的门槛被抹平了,只要会说话,AI 就能构建一切。
但把这套玩法搬进真实生产环境的人,很快遇到了一些共同的麻烦。社区里的翻车总结来来去去就三条,条条致命:
安全漏洞批量出现。 AI 写得快不代表写得安全。一个 agent 每周写 1000 个 PR,哪怕只有 1% 的漏洞率,每周也是 10 个新漏洞。没有任何关卡,你只能照单全收。
架构没法维护。 Vibe Coding 跳过了设计阶段,一个功能接一个功能地 prompt 下去,三个月后没人——包括你自己,也包括 AI——知道代码为什么是这个结构。没有设计文档,没有架构思路,全是债。
上下文越来越乱。 会话越长输出越差,agent 会丢失之前的决策,代码开始自相矛盾。而开发者根本没注意到,因为他们已经不读 diff 了。
2026 年初,有人给这种累积成本起了个名字:认知债务(Cognitive Debt)——AI 交互管理不当、上下文丢失、agent 行为不可靠的累积成本。Vibe Coding 创造认知债务的速度,比此前任何开发方式都快。
这个词点醒了我。在软件工程里,写代码从来不是最难的,最难的是维护系统状态的连贯性、保留当初做架构决策的业务意图。AI 生成的海量代码恰恰割裂了逻辑与意图的联系——几个月后,这些代码库会成为无人敢碰的禁区:你不知道当初为什么这么写,AI 更早就忘了当时的上下文。
狂欢与幻灭的落差摆在这里,就不得不追问一个更本质的问题:为什么那些在 Demo 里无所不能的 AI,一旦踏进复杂真实的工程世界,就注定频繁翻车?
二、AI 为什么不可靠:三个底层原因
要回答这个问题,得先摒弃一种拟人化想象:把大模型当成一个「经验丰富、偶尔粗心的资深工程师」。从计算机科学和数学的视角看,这是我们最容易犯的错误。我读到的各种分析,归结起来指向三个层层递进的原因。
1. 概率预测器的宿命:p^n 的指数诅咒
大语言模型的本质,是一个高维概率预测器。它没有在「思考」,更谈不上对计算机体系结构的「理解」——它只是在海量人类语料的统计规律中,计算给定 Token 序列之后,下一个最有可能出现的 Token 是什么。
本质是概率,就带来一个残酷的数学必然:完成 n 个步骤的任务,一次成功率是 p^n。
假设顶尖模型完成单个编码步骤的成功率高达 95%:
任务只有 1 步,它像神一样完美;
10 步连续交互,0.95^10 ≈ 60%,你开始频繁察觉它犯错;
一个包含建表、接口设计、状态切分、异常处理的完整业务功能,大约 50 步——0.95^50 ≈ 8%。
这不是工程问题,不是优化问题,是数学必然。就算未来把单步成功率硬生生砸到 99%,一个 100 步的复杂工程也只有 0.99^100 ≈ 36%。只要 p≠1,随着 n 增大,模型必然在某个不可预知的节点坠毁。
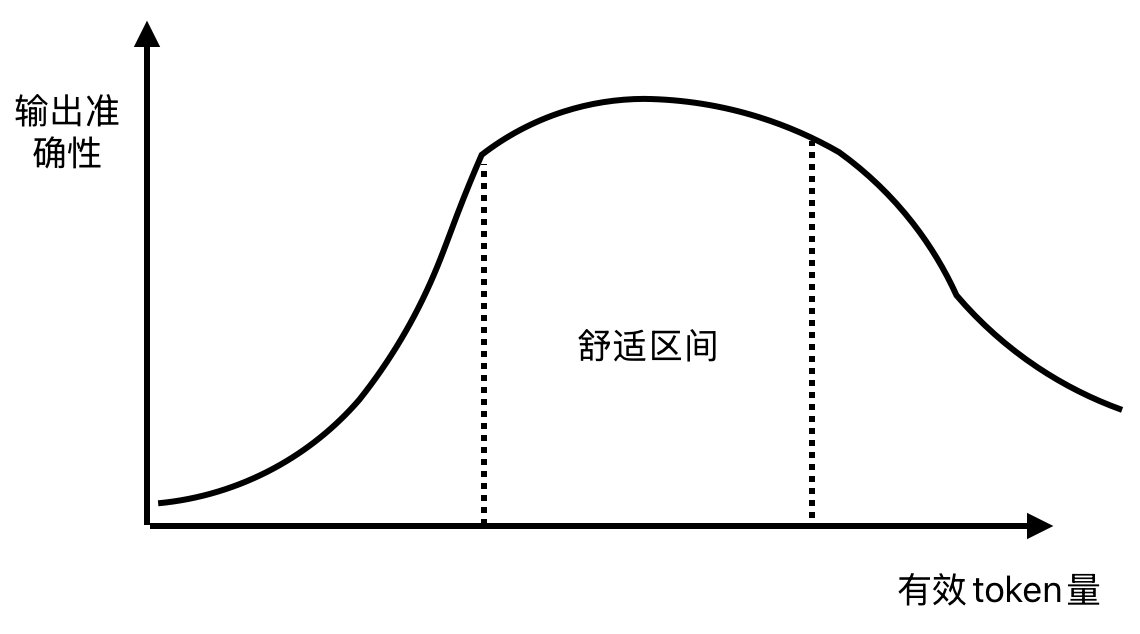
更残酷的是,单步成功率 p 本身并不是一个常量,它极度依赖于你喂给 AI 的上下文(Token)质量。
从上图的“输出准确性—有效 Token 量”曲线可以清晰地看到这个非线性过程:
信息不足(曲线左侧): 缺少必要的上下文,模型被迫依赖概率猜想,引发“幻觉”,p 值剧烈下滑;
舒适区间(曲线顶点): 背景信息精准完整,模型注意力集中,p值达到峰值;
信息过载(曲线右侧): 盲目塞入过多冗余 Token,触发“Lost in the Middle”效应,注意力被稀释,准确率再次断崖式下跌。
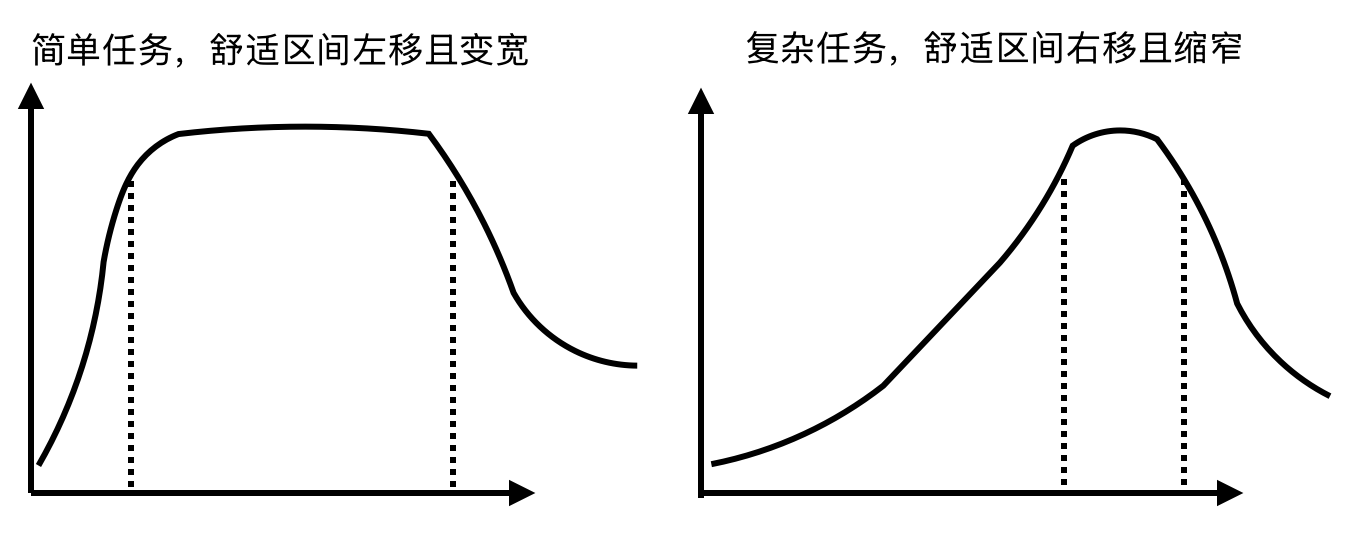
当任务从“简单”走向“复杂”时,这个困局会被进一步放大——复杂任务的“舒适区间”不仅会右移(需要更多背景知识才能启动),而且会急剧缩窄。 多一分冗余会干扰推理,少一分约束会导致遗漏,这使得单步成功率 p 在复杂场景下极难维持在极高位。
人类主导的系统中,我们用确定性的逻辑对抗业务的熵增;而把流程全权委托给 AI,实际上是把确定性的工程替换成了概率性的赌博。
插一句我自己读这段推导时的反应:第一反应不是悲观,而是反过来想——既然衰减来自 n 太大,那工程上能做的事就清楚了:降 n,或者把某些环节的 p 强行顶成 1。这个念头后来成了我整理后半篇的主线,先按下不表。
2. Skin in the Game:对后果的「漠视」
塔勒布有个概念叫「切肤之痛」。我们为什么相对信任资深工程师?因为人类社会的信用体系建立在风险共担之上——深夜排查线上故障的程序员会反复查日志、小心翼翼地改配置,因为草率导致公司损失,他要被问责,生计会受威胁。正是这种恐惧,让人类演化出了自我纠错机制和敬畏心。
AI 是一个毫无痛感的概率幽灵。你在提示词里写「如果你写错了会有十万人失业」,这种「情绪提示词」或许能改变它输出的局部概率分布,让它「扮演」得更严谨一点,但它依然毫无痛感。它不关心这行代码指向内存泄漏还是误删核心库,它唯一优化的目标,是输出一段统计上最像正确答案的字符序列。
一个会犯错、又对错误后果毫无畏惧的执行者,不能把复杂系统的控制权全盘交给它。
3. 莫拉维克悖论:错误边界不可预判
人类能力的成长有严格的层级递进性。一个能设计分布式秒杀系统的架构师,不可能今早突然忘了 HTTP 协议——作为管理者,你对他的错误边界是有预期的,可以针对性地设 Code Review 和压测。
大模型身上却在重演认知科学里的「莫拉维克悖论」:它能瞬间完成极度困难的抽象任务,却在基础常识的底线上轰然坍塌。前一秒像架构大师一样跟你探讨 Raft 与 Paxos 的优劣,下一秒让它把结论写进 Markdown 文件,却迷失在基础的文件流闭合逻辑里;能生成漂亮的 React Hooks 状态流转,却在 CSS Flex 居中上反复翻车。
它的高耸入云,不建立在坚固的地基上。当你连错误的边界和类型都无法预判时,根本无从设立检查点——人类写单测的常规逻辑防不住 AI,因为 AI 写出的 Bug,往往超越人类对「犯错」这件事本身的想象力。
三、为什么偏偏是软件工程:当概率撞上「本质复杂性」
让 AI 写公关稿、画插画,翻车的代价只是几张废稿。为什么一进软件开发领域,后果就成倍放大?
1986 年,Fred Brooks 在《没有银弹》里把软件开发的困难分成两种:附属性复杂性——配置环境、语法转换、样板代码这类工具带来的麻烦;本质复杂性——现实世界错综复杂的业务逻辑本身,比如金融清算规则、电商逆向退款流程。
回过头看,人们对 Vibe Coding 的狂热,本质是混淆了这两种复杂性。
AI 确实是击碎「附属性复杂性」的银弹,它消灭了手写样板代码的时间。但与此同时,它正在把「本质复杂性」绞成一团死结。
软件工程有自己的熵增定律:系统只要在不断修改,架构必然腐化。人类架构师尚且受排期压力所迫,在代码库里挂各种特化参数;不加约束地让 AI 接管迭代,面对庞杂的隐性业务知识,它既没有「妥协的美学」,也不懂「康威定律」——它解决冲突的唯一方式,是用最快、最直白、也最脆弱的意大利面条式代码,去强行满足 Prompt 里的字面需求。
它帮你省下敲击键盘的 10 分钟,预支的却是未来排查逻辑死结的 10 个小时。代码从来不是资产,而是负债——这句话在 AI 时代不但没有过时,反而更刺骨了。
四、Harness:系统工程的四条安全带
如果 AI 注定是不可靠的概率盲盒,而软件工程又天然趋向腐化,难道只能封杀大模型?
那篇微信长文给出的答案,和我从其他地方读到的思路殊途同归:对抗个体不可靠性的解法,人类社会在工业革命和现代 DevOps 的演进里早就找到了——系统工程。
为什么成熟的科技企业敢让几千名水平参差不齐、偶尔还犯低级错误的程序员共同维护核心交易系统?因为被信任的从来不是「个人的绝对可靠」,而是「研发管道」。哪怕有人酒后把 delete 写成全表删除,静态扫描和自动化测试的层层铁网也能把它拦下来。我们接受个体必然犯错,用系统框架清零全局崩溃的风险。
面对 AI,需要的是同一次认知跃迁:停止乞求大模型变聪明,转而构建一套严密的系统去驾驭它。
这就是 Harness——原意是赛车手的安全带,在 AI 语境下指一套包裹在模型外围的运行环境。AI 的不可靠性在这套环境里被捕获、限制、降级,最终让系统向外输出确定性。
那篇长文里最打动我的,是它把 Harness 拆成了一组非常具体的零件:Rule 定红线、Skill 固化标准动作、Scripts 做硬门禁、Sub Agent 分工、Workflow 管接力。这套零件清单值得直接读原文,这里不赘述。消化之后,我更愿意从「这套系统到底在对付什么」的角度,把它归成四个维度:
1. 上下文工程——把控「记忆域」。 很多开发者有种错觉:把整个仓库塞进 200K 长上下文,模型就全知全能。但「Lost in the Middle」效应无情地证明,信息过载会导致注意力稀释、产生幻觉。正确的做法是最小特权上下文——基于 AST 或 LSP 精准提取与当前任务强相关的接口声明和类型定义,让 AI 始终在认知舒适区内运算。微信长文里「每一棒只给当前该看的那一份材料」的上下文纪律,说的是同一件事。
2. 约束工程——缩小爆炸半径。 自由是系统可靠性的天敌。不给笼统的 bash 权限或全局数据库写权限,只暴露原子化、强校验的工具接口;用 Zod、Pydantic 之类的 Schema 校验强制 AI 输出严格结构,类型不符就直接截断重试,脏数据绝不流转下游。长文里那句「Rule 是软约束,Scripts 才是硬门禁」——AI 理论上应该遵守 Rule,但它会忘、会觉得与本次需求无关、会给自己找理由——是我认为全文最值得划线的一句。
3. 反馈回路——用确定性捕获概率性。 没有自我纠错能力的 AI,必须靠外部环境为它构建回路。生成的代码抛进隔离沙盒跑预设测试,通过才能成为候选代码;抛出异常,就把错误堆栈精准反哺回去勒令重写。用确定性的编译器错误和测试用例逼迫概率模型收敛,是驾驭 AI 最高级的手段。
4. 可观测性——击穿认知黑盒。 传统 APM 监控 CPU 和内存,Harness 要监控的是「认知链路」:哪一步调用了什么 Prompt、消耗多少 Token、触发了哪次 Tool Call、推理延迟多少。没有这些,出 Bug 时你只能对着错误代码发呆,不知道 AI 抽了什么风。
四个维度做的事其实是同一件:给概率预测器套上确定性的外壳。
五、Agentic Engineering:三条工作纪律
如果说 Harness 是底层防御基建,人的工作方式也要跟着变。2026 年初,亲手带火 Vibe Coding 这个词的 Karpathy 自己按下了暂停键,承认毫无约束的 AI 生成引发了难以估量的代码债务,转而提倡 Agentic Engineering——更严格的监督、更结构化的拆解、更严密的审查。
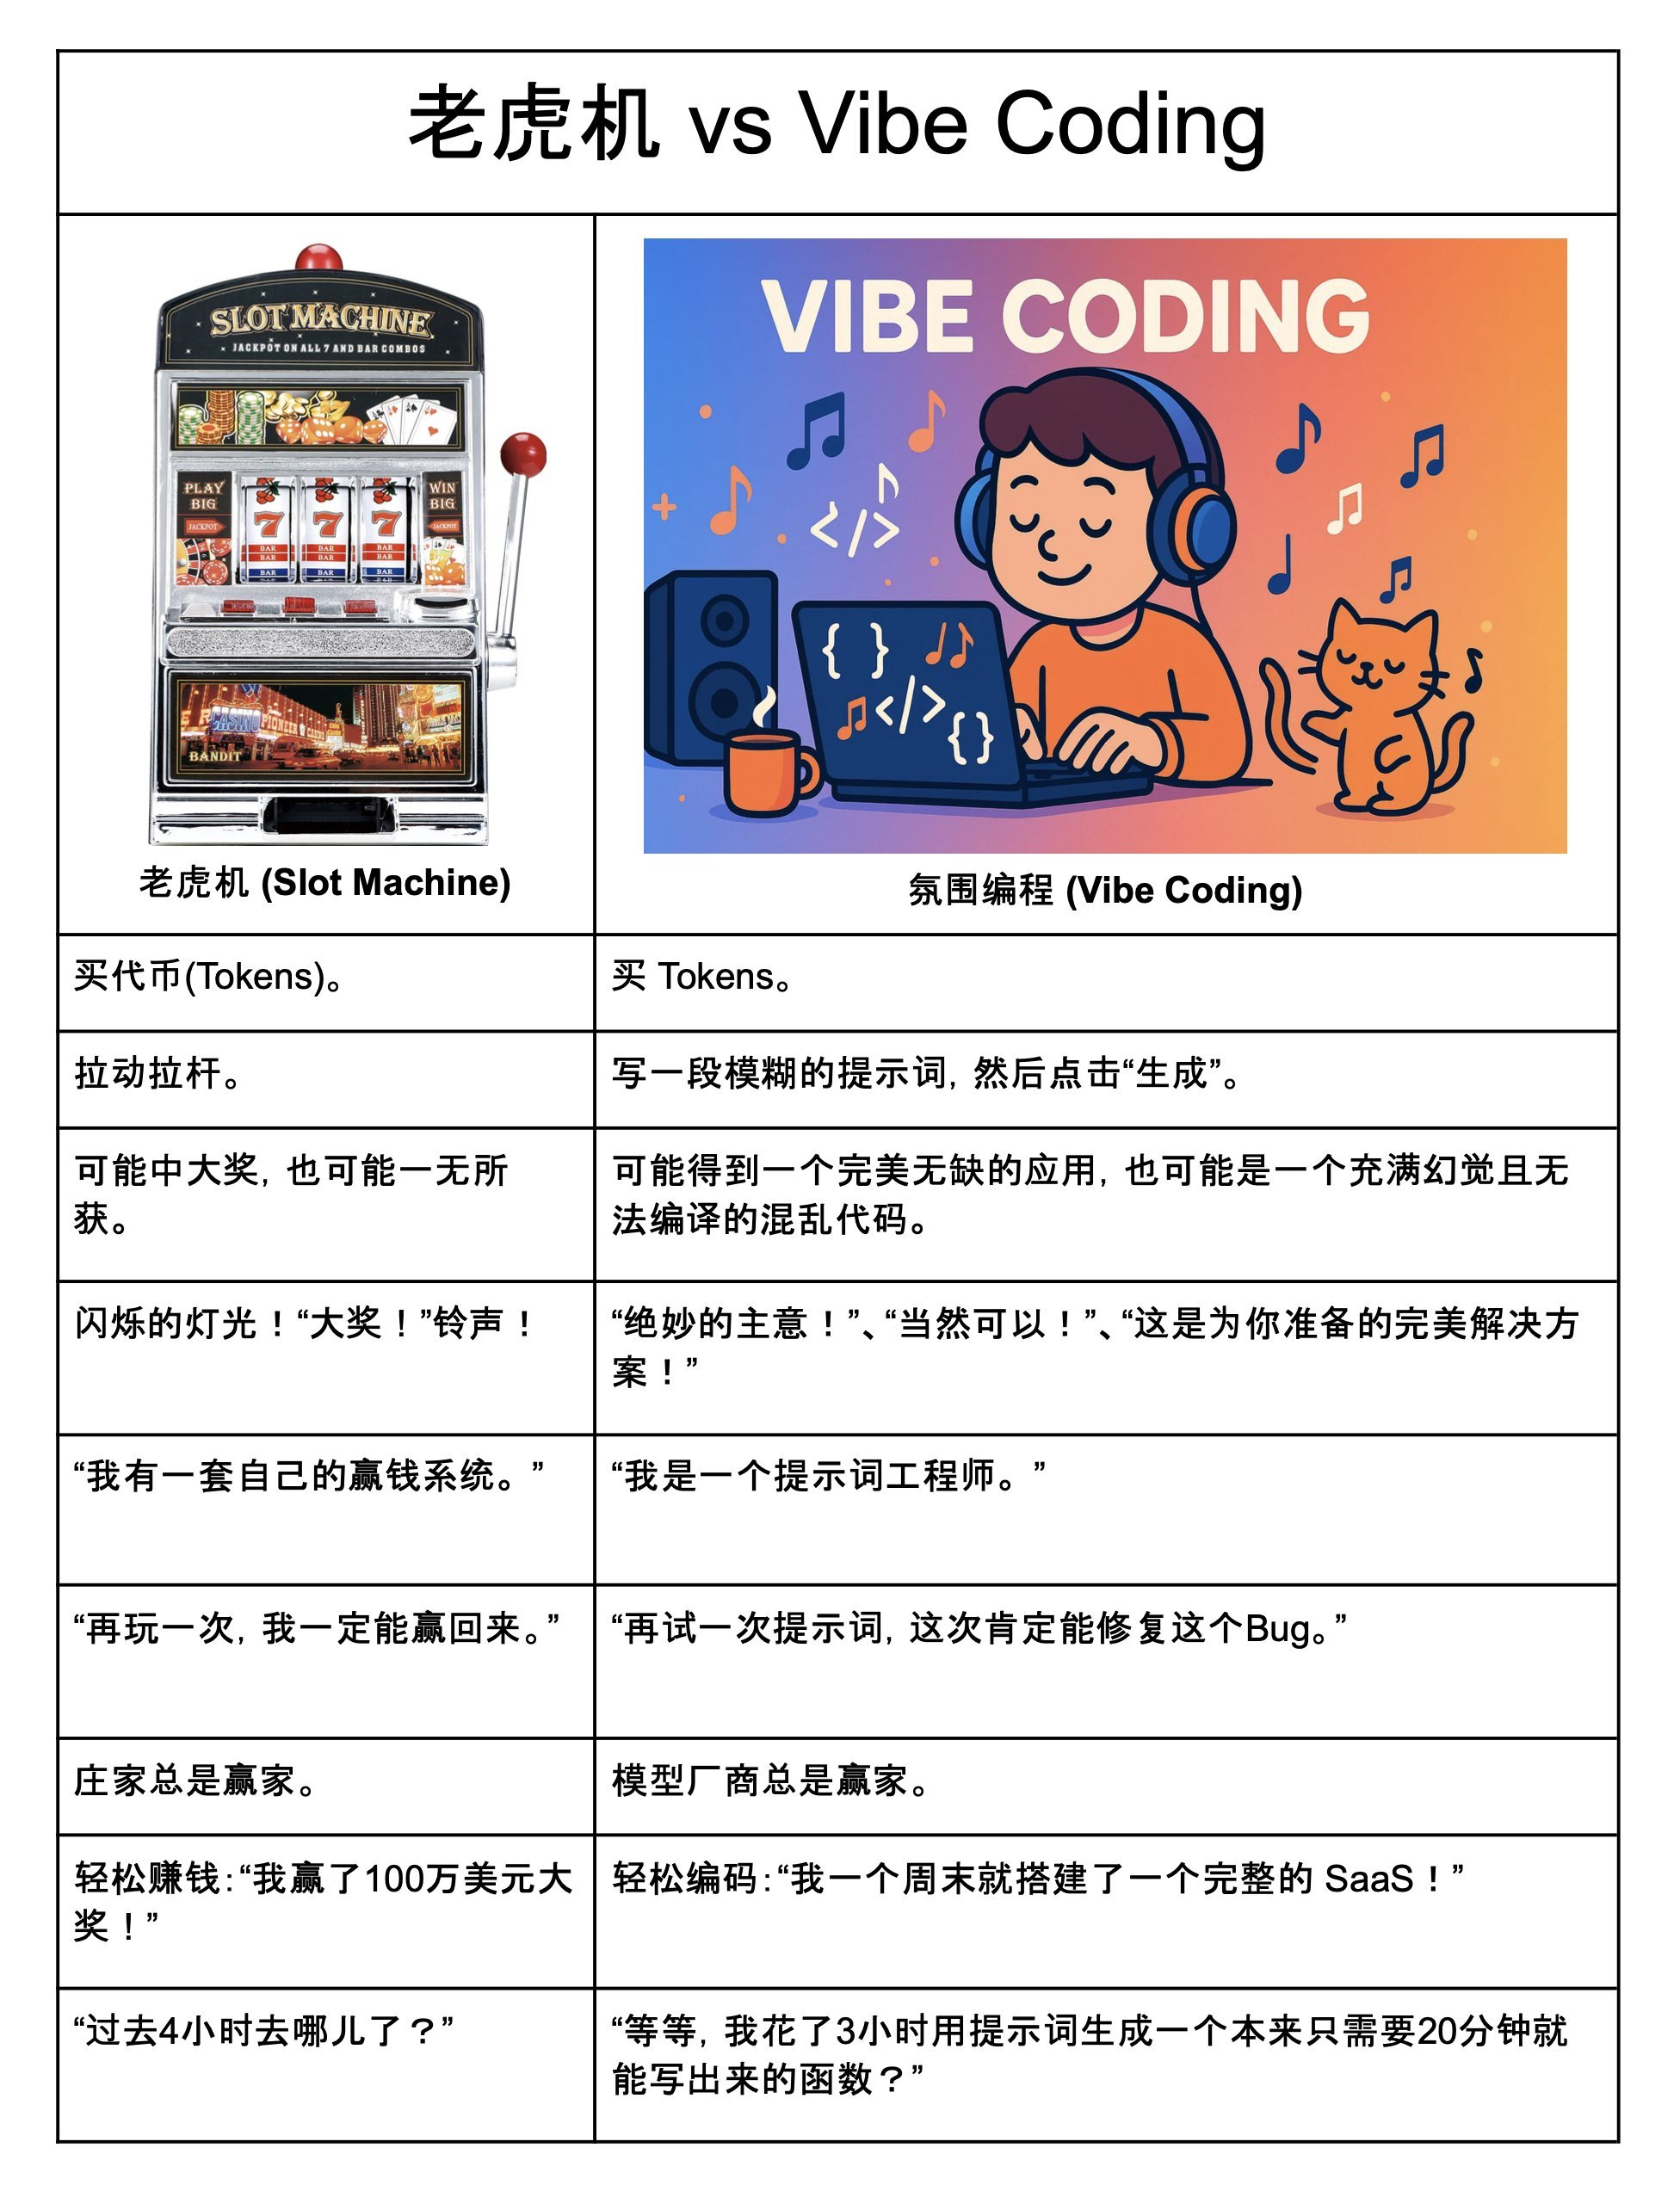
有一张对照表流传很广,值得贴在这里:
核心要义一句话:AI 负责构建,人类负责兜底。 落到一线,我把它收成三条纪律。
原则一:确定性优先——能用代码固化的,绝不用 AI 去猜
回顾前面的 p^n 困境,破解概率衰减最暴力的手段,就是把 n 降下来、把 p 顶到 1。
「帮我把项目打个包,Debug 开 x 配置,Release 开 y 配置」——这是在人为增加概率环节,AI 明天就可能漏掉一个参数。正确的做法是精心写一个 build.sh 固化逻辑,指令只剩一句「执行 sh build.sh release」。
同理,绝不要指望 AI 代替静态扫描。引入扫描工具并把规则写死——它确实没有大模型聪明,但它拥有大模型永远无法企及的特质:100% 的绝对确定性。把这些环节固化,就是把 p^n 链路里的概率替换成 1。
原则二:收敛可能性空间——强行划定边界
面对开放性问题,大模型的表现往往是发散且灾难性的;在极度约束的条件下,它才能爆发出惊人的生产力。
「帮我优化一下这个接口,太慢了」——此时 AI 面前有无数条路(改算法、加缓存、上消息队列),它极大概率挑一个最不适合业务现状的方案,把系统改得面目全非。换成:「这个接口瓶颈在 MySQL。请严格在这个边界内:仅使用 Redis 旁路缓存;Key 带 user_id 前缀防冲突;TTL 统一 5 分钟;禁止引入任何外部依赖。」
你看似在写 Prompt,实际在做软件工程最核心的决策:划定业务与技术的边界。 这一条是我自己实践里体感最强的——提示词写得越像一份小型技术方案,返工越少;写得越像一句口头禅,代码越像抽奖。
原则三:Spec 驱动 + 极端审查
对抗不可靠性的最高法则,是阶梯式交付,在每个节点做强人工重置——把概率强行拉回 100%。社区里总结的操作步骤大体四步:先写规格说明书(在 agent 碰任何文件之前完成);拆成小任务(「用现有邮件服务实现密码重置,Token 存 Redis,15 分钟 TTL」这种粒度);像审查人类 PR 一样审查每一个 diff;测试通过才发货,而且是你写过或审过的测试。
其中最关键的是一次心智反转:代码是极易报废的负债,梳理过的 Spec 才是能长久沉淀的资产。 哪怕这轮代码生成失败了,那份确定的 Spec 也是下一轮的黄金上下文。至于审查——AI 改了 200 行,哪怕「看起来能跑」,也必须逐行读;看不懂它为了炫技用的某个生僻 API,就决不允许合入。你不知道的逻辑,就是未来的线上定时炸弹。
六、回到原点:个体不可靠,但可以可控
写到这里,视角需要再拉回一层。
无论如何优化,AI 依然是不可靠的。我们无法确定给它的信息是否足够,也不知道它此刻工作在能力曲线的哪个区间。前面讲透的 p^n 和切肤之痛,不会因为加了几条安全带就消失。
但若就此止步,结论会过于悲观。真正值得追问的不是「AI 是否可靠」,而是——AI 的不可靠性是否可控。
这个追问之所以成立,是因为一个常被忽略的事实:人也是不可靠的。 人会犯错、有情绪、会请假、会在凌晨三点改错配置。把 AI 的不可靠当成异类,其实是另一种拟人化的傲慢。一支成熟的人类研发团队里没有人绝对可靠,但团队整体可以输出相对可靠的结果——原因不在「招到了神」,而在系统替个体兜底:需求评审挡掉拍脑袋,Lint 挡掉低级错误,Code Review 挡掉理解偏差,测试分层挡掉逻辑回归,CI/CD 挡掉破坏主干的合入,人员互备挡掉单点依赖。每一层都在用系统的确定性对冲个体的概率性。
理解了这一点,对 AI 的判断就完全变了:问题不是 AI 不可靠,而是不可靠性有没有被收进一个可控的容器里。
这也是我对 Harness Engineering 的最终定义:让 AI 可控、可用、可持续的系统工程能力。 它不是某个工具,也不是某条提示词技巧,而是一套把个体不可靠性收编为系统可控性的工程实践。
落到分工上,是一条很朴素的边界:AI 负责大部分「脑力+体力」输出——写代码、写文档、跑测试、生成候选方案;人类负责评估和决策——定边界、审 Spec、拒掉糟糕的提案、在流程卡住时做最终判断。某种意义上这是声明式编程的延伸:人提供 What,AI 提供 How,人再验收 How 的结果。注意,「人类负责决策」不等于「人类要懂每一行代码」,人类负责的是质量与商业后果的兜底——这正是切肤之痛的真正落点。AI 没有痛感,所以痛感必须由人来补。
责任主体永远是人。这不是情怀,是工程上的必然——因为只有人承担后果。
评论区