

起初接触 Hiclaw,是 3 月底阿里云那场「AI原生应用开源开发者沙龙」,Hiclaw + CoPaw 发布介绍 + 现场上手实操会。作为首批用户,从 1.0.3 版本开始用起来,统一网关鉴权、文件同步、容器化的自动管理、Manager角色的统筹分工给各个Agent协作之后再汇总报告、 文档与安全边界、把"零信任"和"多 Agent 协作"从第一天就当成底层前提,而不是后来打的补丁——这些设计,是让人心生敬意的。
用得深了,碰到的问题自然也比别人多些。官方的文档还很薄,官方小助理机器人问多了会认真地给我它想象出来的答案,于是遇到问题只剩一条路 —— 自己往源码里翻。翻了一个多月,顺手给官方提了几个 BUG 类 issue,也提了些建议。
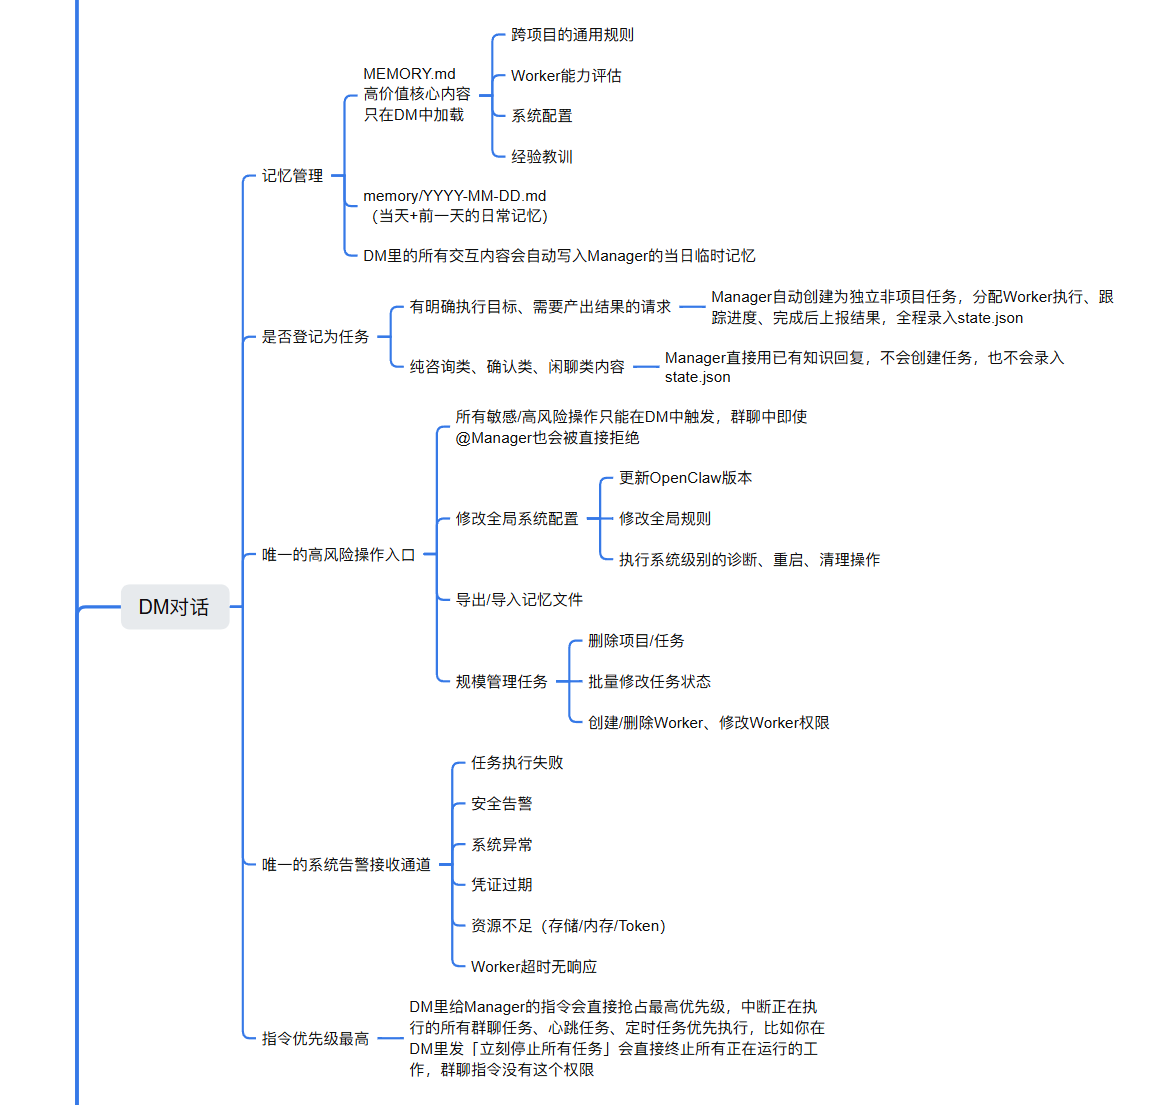
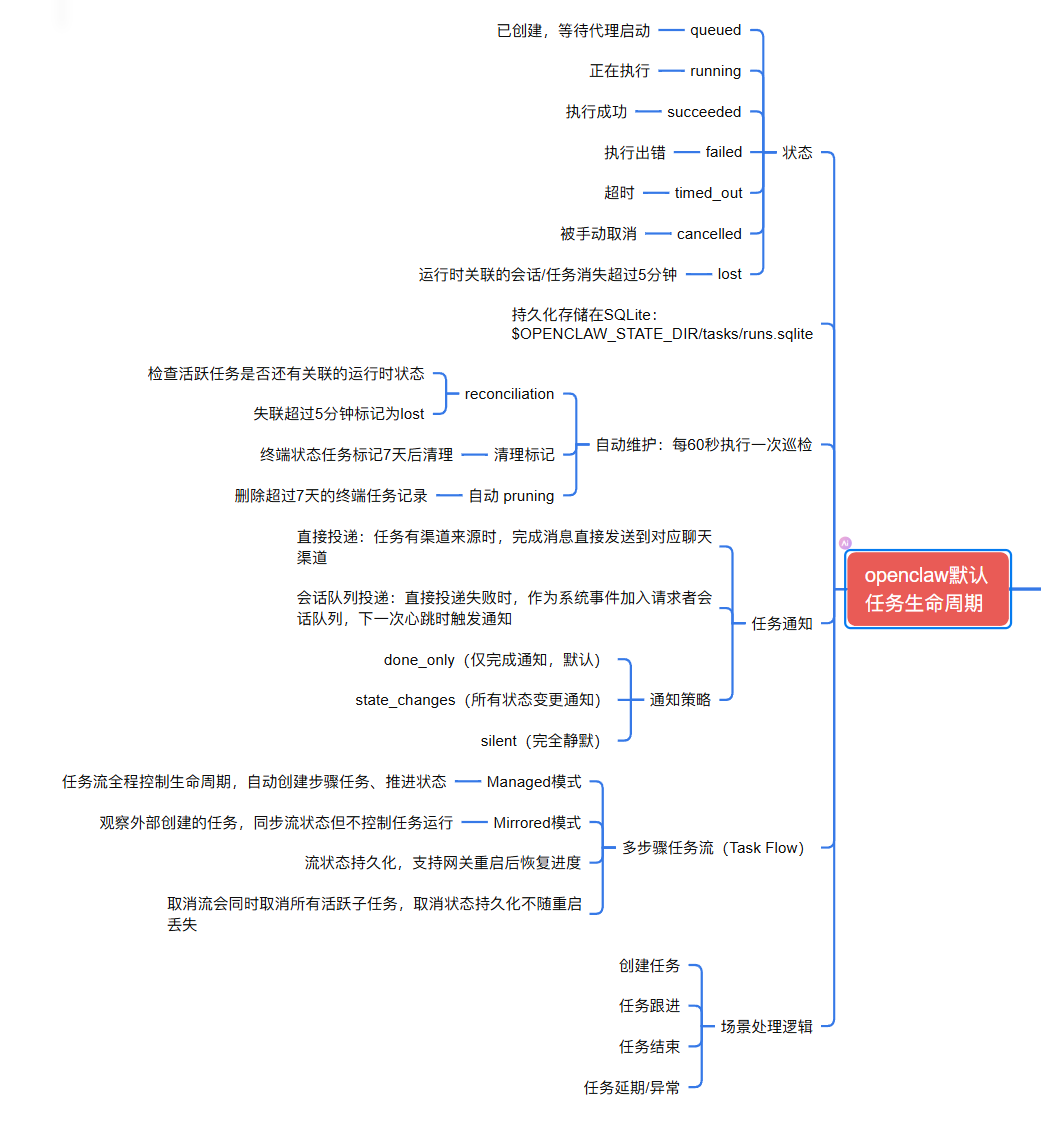
真正想写这篇文字的契机,是扒完源码之后:AI 完全能自动生成这种程度的架构思维导图,但出于学习目的、为了加强记忆和理解,还是自己一点一点理清楚、画了出来。
完整脑图链接:
部分脑图:
文中的运行原理部分,源自我把整套源码分析沉淀成的 7 个模块文档(对齐 4 月下旬的代码版本),分别对应 Hiclaw 的 7 个核心子系统。下面按这 7 个模块组织。
HiClaw官方GitHub仓库:
https://github.com/alibaba/hiclaw/blob/main/docs/zh-cn/architecture.md
一、架构解析:7 个核心子系统
先说清一件事:Hiclaw 自己并不实现 Agent 逻辑,它编排和管理多个 Agent 容器——一个 Manager 加众多 Worker。它对标的是"Team 版 OpenClaw":让多个 OpenClaw 类 Agent 在一个受控、可审计的房间里协作,人类全程可见、随时可介入。所以下面要拆的不是"它怎么实现 Agent",而是"它怎么编排 Agent"。
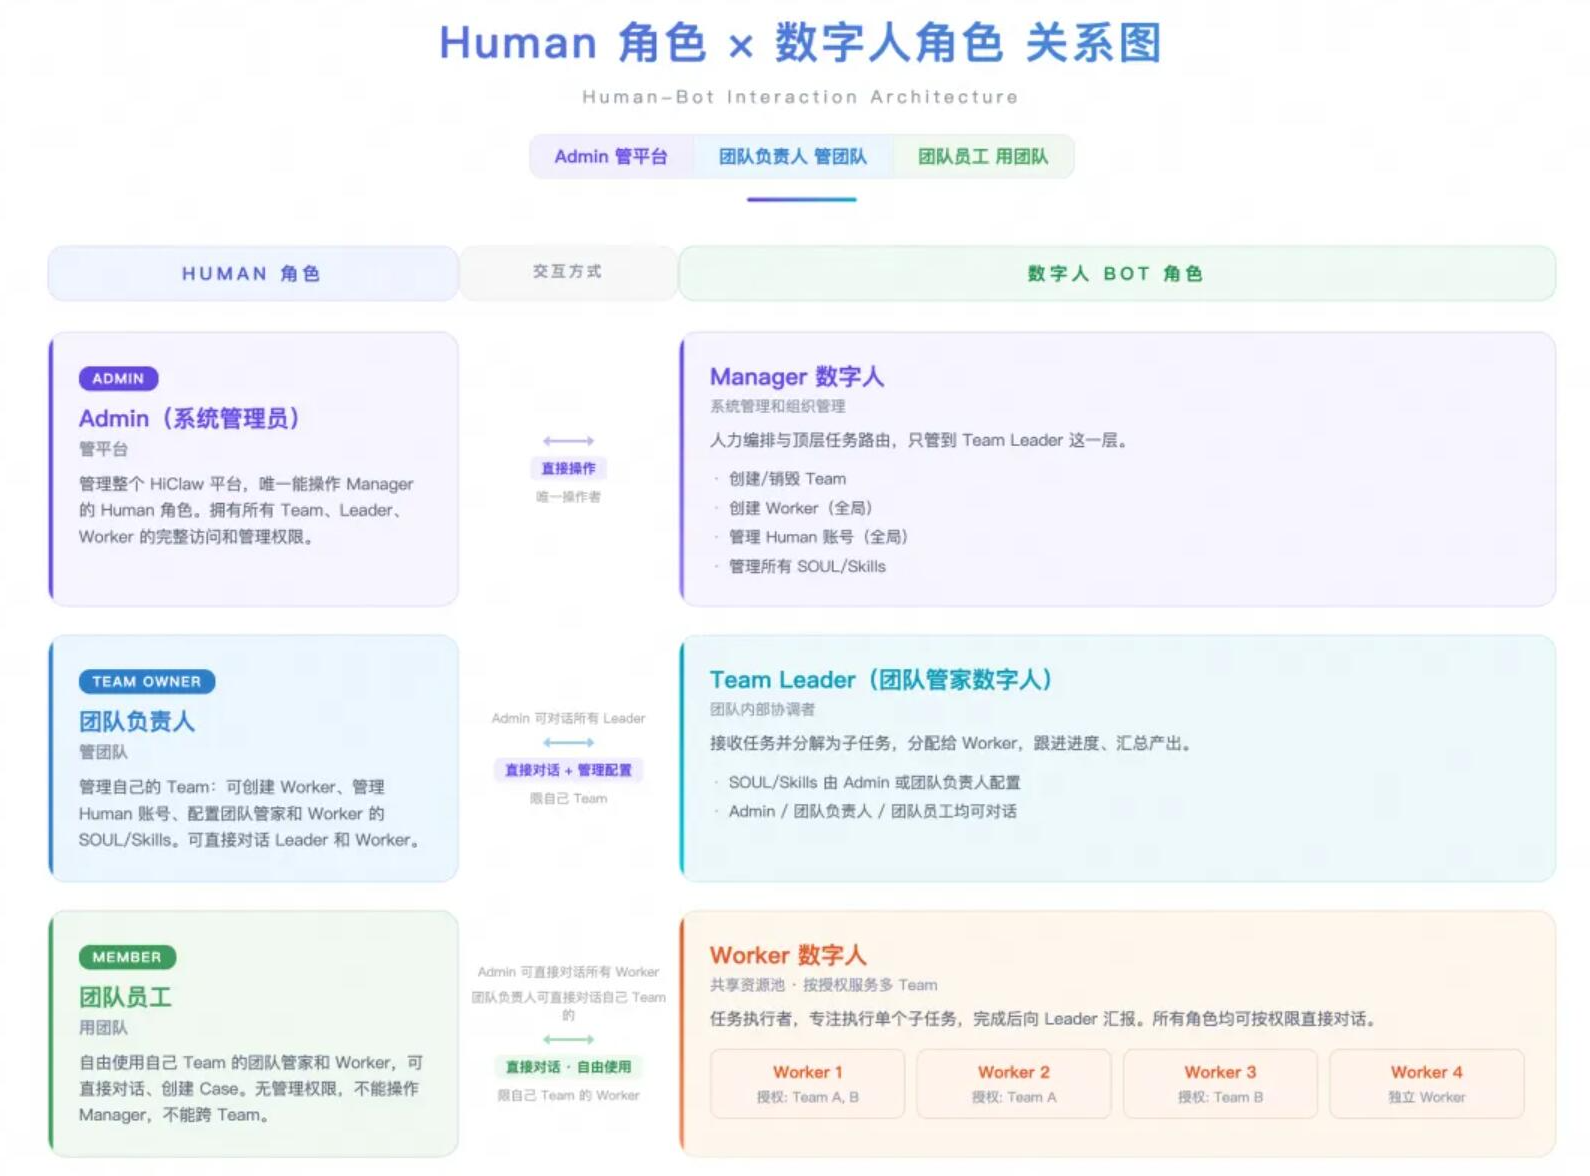
1. Agent 系统:生命周期与配置注入
所有 Agent(Manager、Team Leader、Worker)共享同一套生命周期——创建、启动、运行、销毁。区别只在配置文件和角色模板。
创建由 Manager 通过 create-worker.sh 执行。前置条件是先在 /root/hiclaw-fs/agents/<WORKER_NAME>/ 下创建 SOUL.md(核心身份规则),脚本再据此生成 openclaw.json、AGENTS.md、mcporter 配置,最后同步到 MinIO。
启动阶段入口是 worker-entrypoint.sh,顺序很固定:配置时区与 MinIO 客户端 alias → 从 MinIO 拉取 Worker 配置和共享数据 → 强制验证三个文件存在(openclaw.json、SOUL.md、AGENTS.md,最多重试 6 次、间隔 5 秒,缺失即退出)→ 启动本地→远程的 5 秒推送同步与远程→本地的 5 分钟 fallback 拉取 → 从 MinIO 读取 Matrix 密码重新登录以避开 E2EE 会话问题 → 执行 openclaw gateway run --verbose --force。
运行阶段每次新会话触发,按固定顺序读取 SOUL.md 和 memory/YYYY-MM-DD.md(今天 + 昨天)。这条"会话启动强制读取 SOUL + 今昨记忆"的规则,写在所有类型 Agent 的 AGENTS.md 第 23 行——Manager、普通 Worker、CoPaw Worker、Team Leader 一视同仁。
销毁阶段:容器被删除时本地临时数据丢失,但 MinIO 里的配置、记忆、技能永久保留——这是"无状态设计"的关键。
设计意图:把"身份"(SOUL.md)、"工作流程"(AGENTS.md)、"记忆"(memory/)、"配置"(openclaw.json / mcporter.json)拆成不同归属、不同优先级的文件——SOUL.md 优先级最高,任何其他配置不得与之冲突。既给出稳定的人格底座,又不剥夺用户的自定义空间。这个分层,比我此前自己纸面推演的方案干净得多。
2. Worker 团队系统:Team Leader 与 Worker 的角色分野
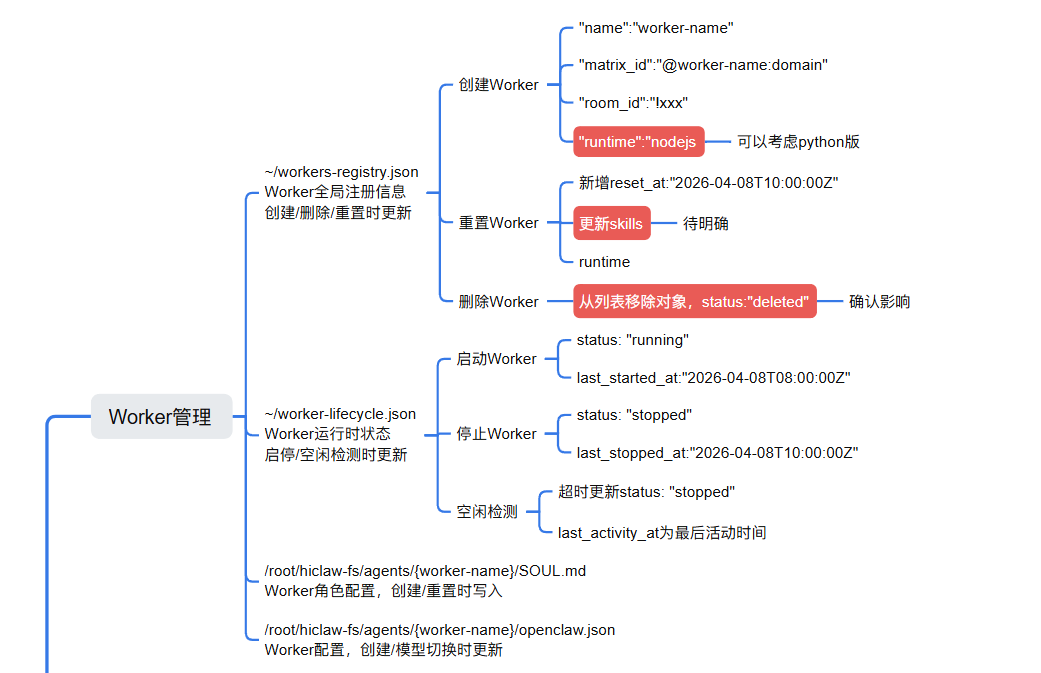
Worker 分两种角色,由 create-worker.sh 的 --role 参数决定,取值 worker(默认)或 team_leader。
角色决定三件事:AGENTS.md 模板(工作流规则)、内置技能包(Team Leader 多一套 team-task-management)、权限范围(Team Leader 可拆解子任务分派给团队成员)。汇报链路分得很清楚——普通 Worker 直接向 Manager 汇报;Team Leader 向 Manager 上报聚合后的团队结果,团队内部问题自行协调、仅严重问题上报。通信规则上,普通 Worker 仅响应 Manager 和 Admin 的 @mention,Team Leader 还可 @ 团队内 Worker 分派任务。
容器创建走 Docker run,参数来自 Worker 名称、MinIO 凭证、可选环境变量、自定义镜像、运行时类型(openclaw / copaw 对应不同基础镜像)。注册信息写入 workers-registry.json,字段包括 matrix_user_id、room_id、runtime、deployment、skills、role、team_id、image、created_at、skills_updated_at——这是 Manager 知道"自己管着哪些 Worker"的唯一依据。
空闲回收设计得相当克制:默认 720 分钟(12 小时)无活跃任务才自动停止,下次有任务再唤醒。判断空闲的规则是四条只要满足任一就不算空闲——state.json 的 active_tasks 里有 finite/infinite 任务、.openclaw/cron/jobs.json 里有 enabled 的 cron 任务、deployment 为 remote、刚启动还在宽限期内。容器被误删也能根据 registry 自动重建。
设计意图:Team Leader 这一层是为了解决"任务复杂度超过单个 Worker 能力"的扩展问题。Manager 不直接面对所有 Worker,而是面对几个 Team Leader,由 Team Leader 再拆给团队内 Worker——典型的层次化调度。
Team 系统其实是我最关注的模块之一,因为复杂任务(如软件研发维护)本身就需要多 Agent 协同,我需要一个除了 Manager 这种管理全局人事的“总助”之外的“业务部门领导” Team_leader 来处理。
但是 Team 系统却又是当前 Hiclaw 系统 BUG 最多的模块,也受限于 Hiclaw 和阿里的另一个对标 OpenClaw 的团队 CoPaw(目前已更名QwenPaw)之间有协同义务,在前几个版本中,Team-Worker 被限制成了只能使用 CoPaw (而非openclaw)作为 Agent 运行时,这两个初创项目的各类 BUG 直接原地叠乘,简直不要太酸爽……
3. 任务管理系统:manage-state.sh 与 state.json
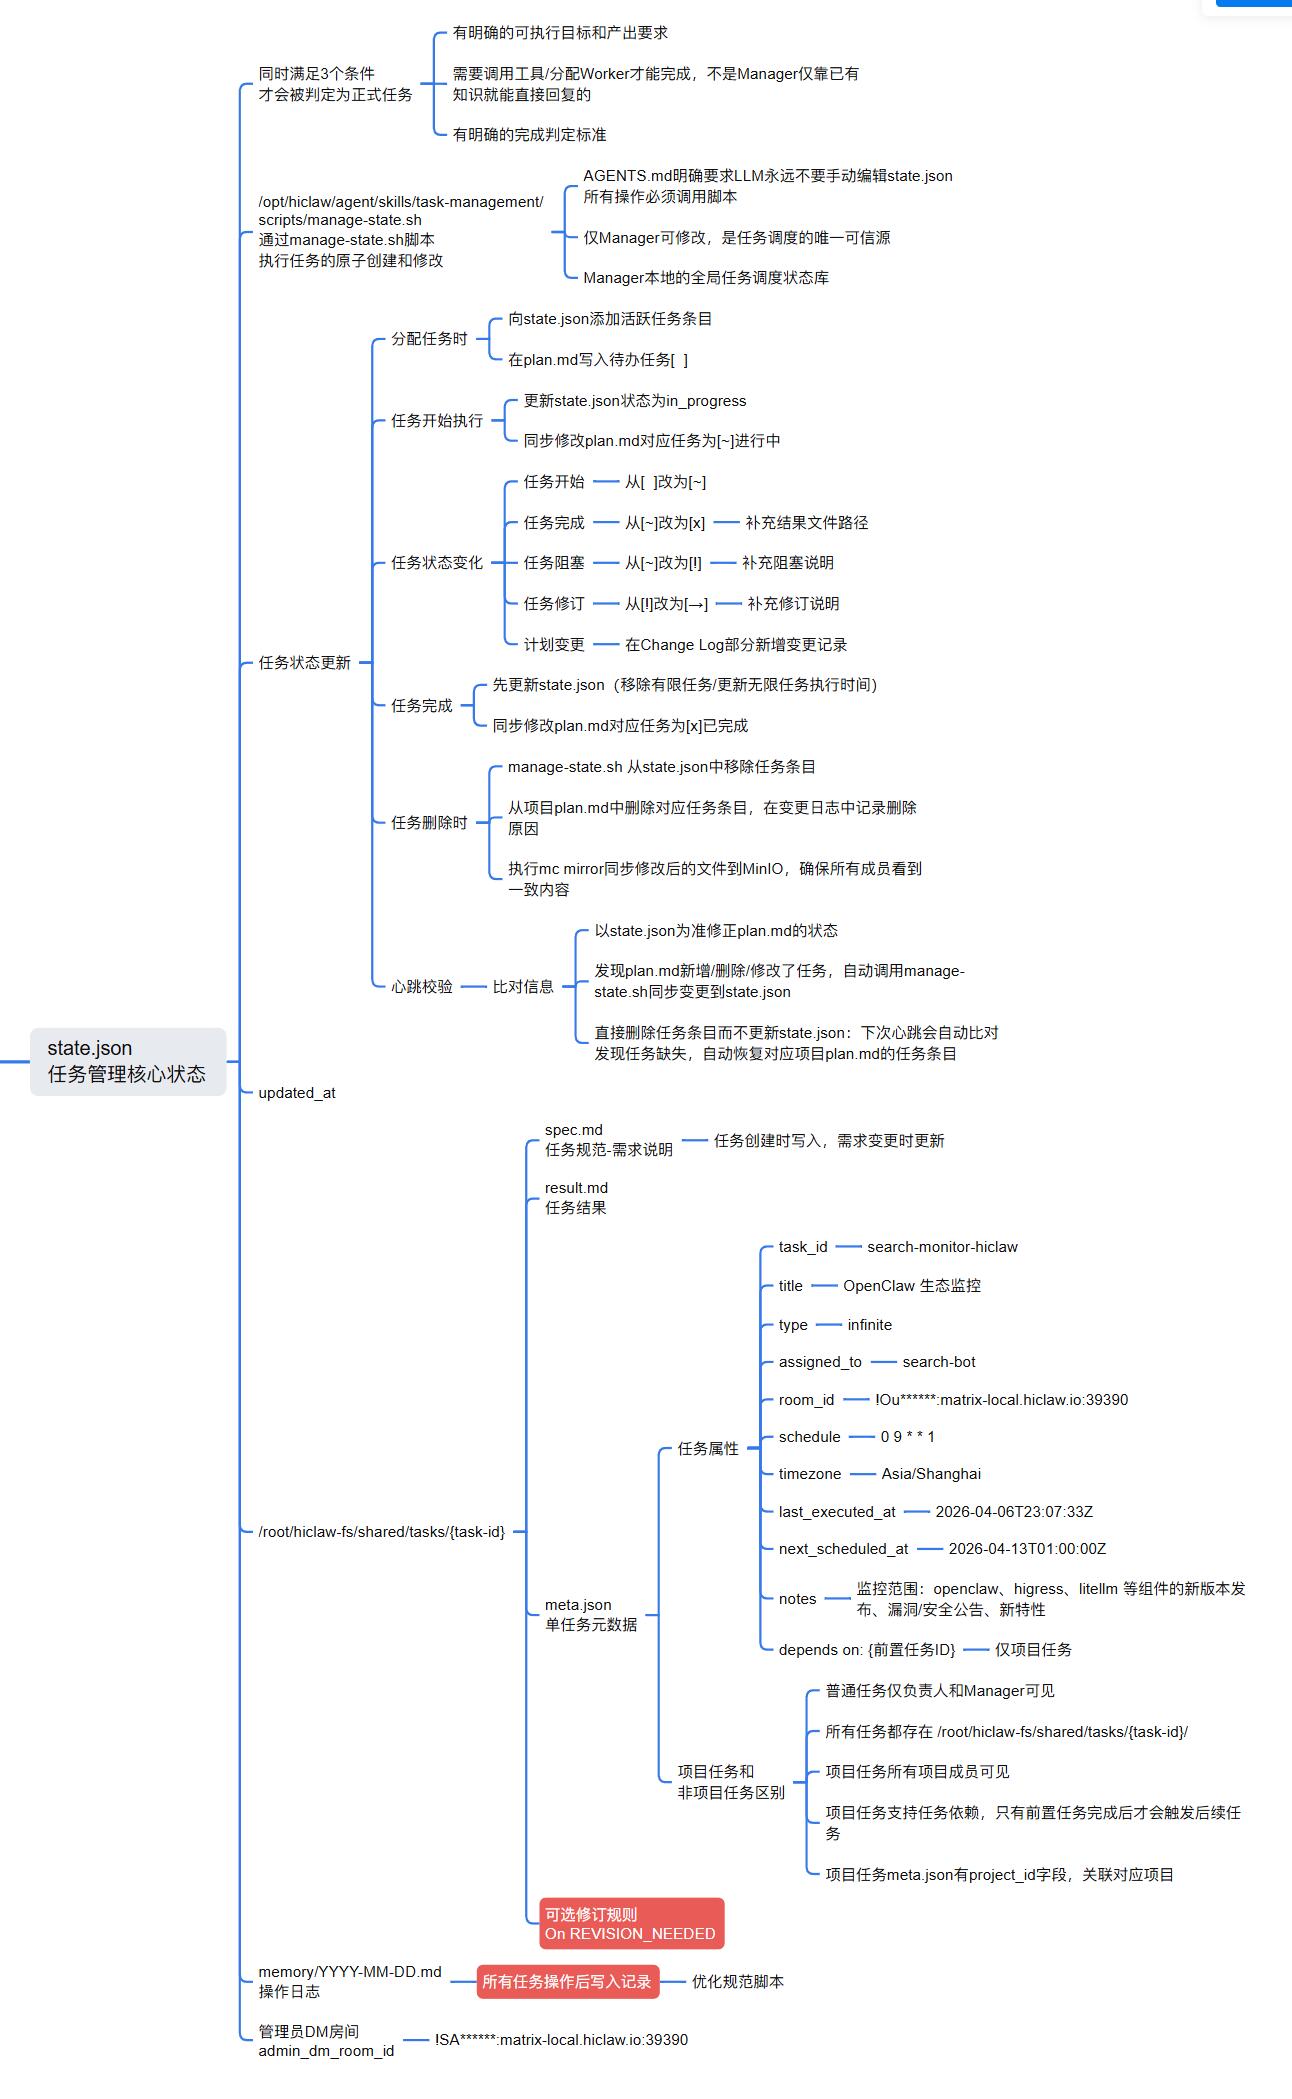
这是整套架构里最值得展开的一节。
任务管理的核心是一个原子操作脚本 manage-state.sh。所有对 state.json 的修改都必须经它执行,避免手动编辑导致状态不一致。支持的 action 是 init、add-finite、add-infinite、complete、executed、set-admin-dm、list——一套非常朴素的状态机接口。
原子性的实现很有代表性,写操作统一走"临时文件 → mv 替换":
tmp=$(mktemp)
jq [修改逻辑] "$STATE_FILE" > "$tmp" && mv "$tmp" "$STATE_FILE"
state.json 的结构同样克制:admin_dm_room_id、active_tasks、updated_at。每个任务条目携带 task_id、title、type、assigned_to、room_id、project_room_id、delegated_to_team、schedule、timezone、last_executed_at、next_scheduled_at。
任务分两类生命周期:
有限任务(finite):创建 → 分配 → 执行 → 完成。任务 ID 格式
task-YYYYMMDD-HHMMSS,目录建在/root/hiclaw-fs/shared/tasks/{task-id}/,写入meta.json与spec.md后推到 MinIO;分配阶段 @mention Worker 并告知 spec 路径,同时--action add-finite入列;执行阶段 Worker 拉取 spec、产出plan.md/result.md、推送、@mention Manager;完成阶段 Manager 校验结果、把meta.json置为completed、--action complete出列、记入记忆文件。无限任务(infinite):周期性业务任务(每日报表、定时巡检、数据同步),永不从
active_tasks移除,只更新last_executed_at和next_scheduled_at。
设计意图:把任务状态机做成"shell + jq + mv"的极简实现。这里有一份朴素的工程美学——不依赖数据库、不依赖消息队列、不依赖锁服务,靠文件系统的原子 mv 做并发安全。部署门槛因此低到几乎没有,对小型私有化部署非常友好。
已发现的问题:文件级原子操作保证的是"单个 state.json 不损坏",而多个 Worker 各持一份副本时的"看到的是同一个版本",靠的是同步机制而不是原子性。这两件事的距离有多大…… 只能说这一个多月以来,我被任务状态不同步引起Manager和各Worker之间扯皮折腾得不轻。
4. 项目管理系统:create-project.sh 与 plan.md
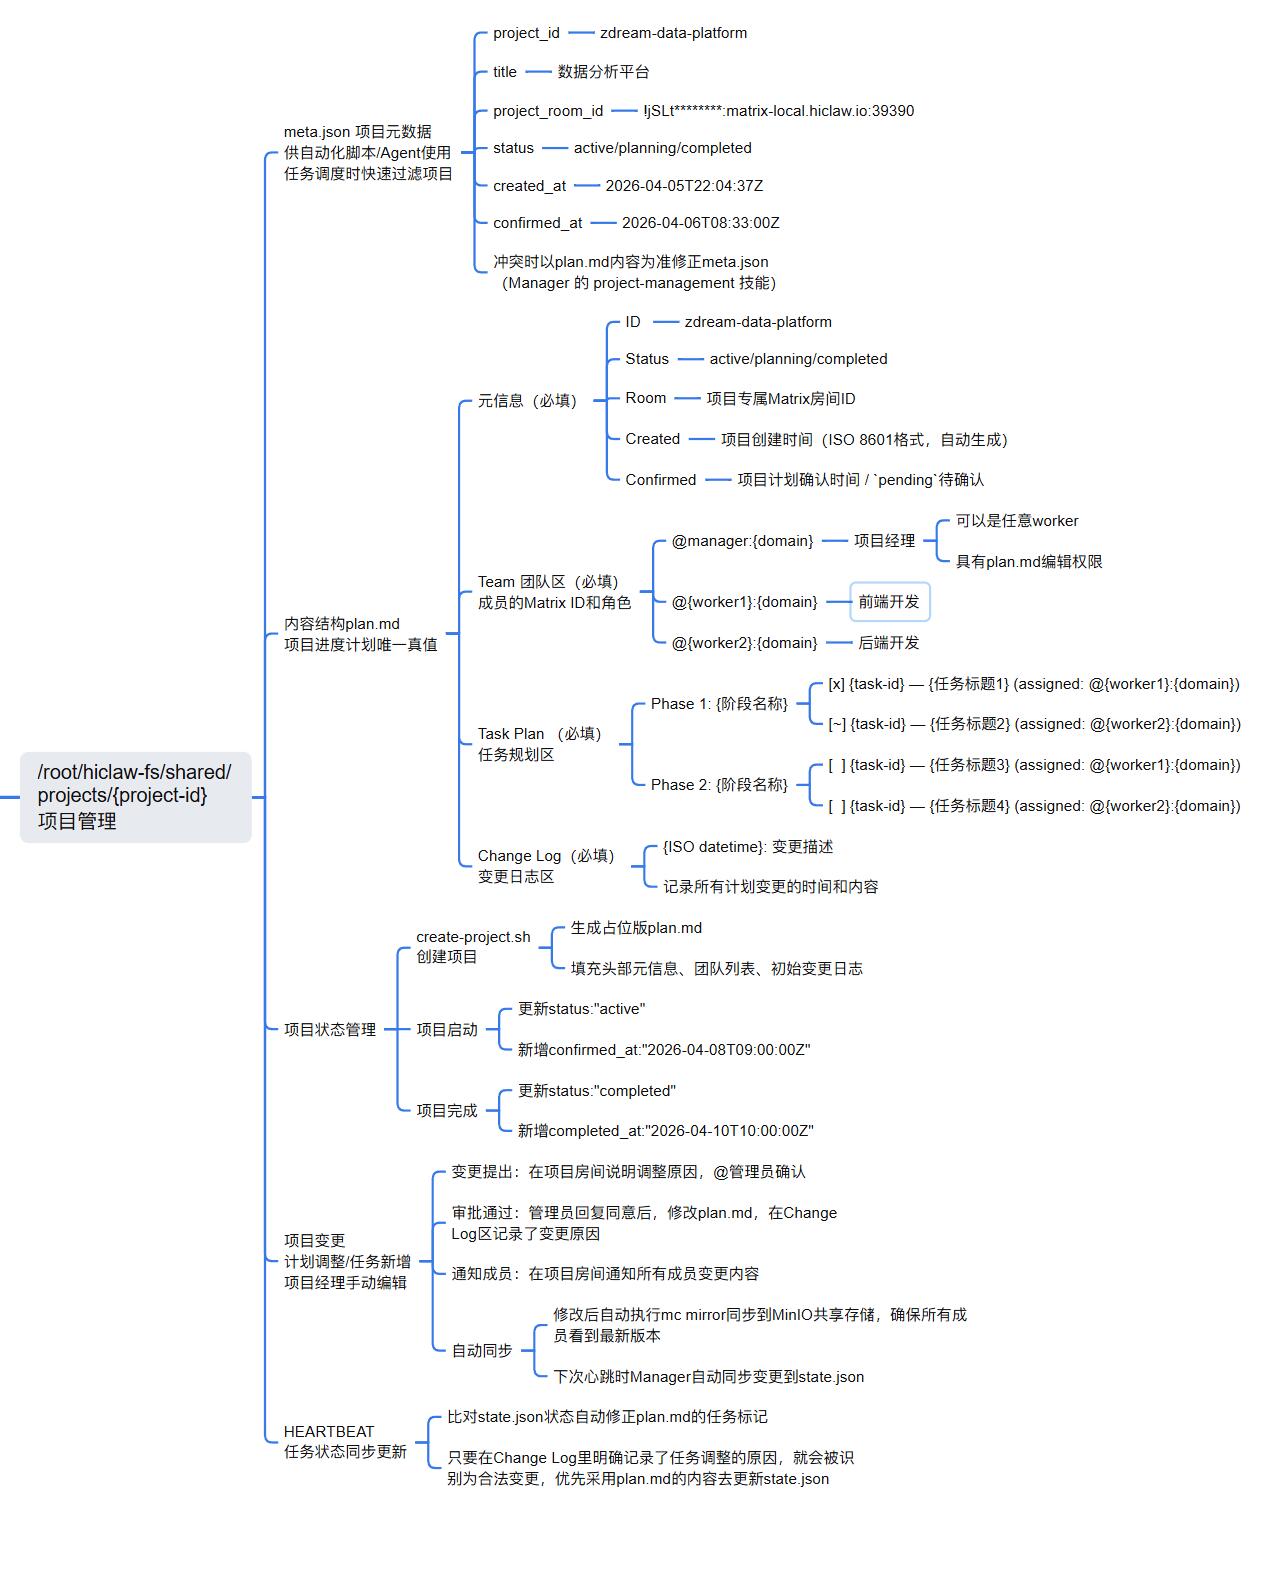
项目是比任务高一层的概念——一个项目包含多个 Worker、一个项目群、一份 plan.md。
创建走 create-project.sh,四步:建项目目录与初始文件(meta.json + plan.md 占位)→ 建 Matrix 项目群(群名 Project: {PROJECT_TITLE},自动邀请管理员 / Manager / 所有 Worker,Manager 与 Admin 权限等级 100、Worker 为 0)→ 更新 Manager 的 groupAllowFrom(加入项目全部 Worker 的 Matrix ID 并去重)→ 同步到 MinIO。
plan.md 的标准格式很有意思,它本质上是一份带状态标记的甘特图:
Project: {title}
ID: {project-id} Status: planning | active | completed
Task Plan
Phase 1: {phase name}
- {task-id} — {task title} (assigned: @{worker}:{domain})
- Spec: /root/hiclaw-fs/shared/tasks/{task-id}/spec.md
- Result: /root/hiclaw-fs/shared/tasks/{task-id}/result.md
Phase 2: {phase name}
- [~] {task-id} — {task title} (assigned: @{worker}:{domain}, depends on: {task-id})
- On REVISION_NEEDED: return to {task-id} | reassign to @{worker}
Change Log
任务状态用 markdown 复选框扩展——[ ] 待执行、[~] 执行中、[x] 已完成、[!] 阻塞、[→] 修订中。修订指令也嵌在 markdown 里:return to {task-id} 退回原负责人,reassign to @{worker} 改派他人。
meta.json 是另一份结构化事实——project_id、title、project_room_id、status、workers、created_at、confirmed_at。两份文件之间有同步约定:创建时同时生成,项目确认、项目完成、以及影响整体进度的任务状态变更,都要同步更新 meta.json。
设计意图:把项目结构(meta.json,机器可读)和项目叙事(plan.md,人类可读)做成两份互为镜像的文件——Manager 读 meta.json 做调度判断,人类读 plan.md 看进度。这是"事实文件 + 叙事文件"的双轨设计,也是这套架构里我最欣赏的一处产品直觉:它没有把人类当成状态机的观众,而是当成状态机的一个节点。
5. 存储与文件同步:Worker 目录、MinIO/OSS、跨 Agent 同步
这是整套架构里工程量最大、也最见功底的一节。
Worker 本地目录分层清晰:
/root/hiclaw-fs/agents/{worker-name}/
├── SOUL.md              # Worker 管理,身份规则
├── AGENTS.md            # Worker 管理,工作流程
├── memory/              # Worker 管理,按日期存储
├── skills/              # 内置 + 自定义技能
├── openclaw.json        # Manager 管理,核心配置
├── config/mcporter.json # Manager 管理,MCP 配置
├── credentials/         # Manager 管理,不同步到本地
├── .openclaw/           # 运行时目录,非持久化
└── shared/ -> /root/hiclaw-fs/shared/  # 共享目录软链接
归属划得很干净——SOUL.md / AGENTS.md / memory 由 Worker 自管,改完从本地推到 MinIO、不会被远程覆盖;openclaw.json / mcporter.json / skills 由 Manager 管,Worker 每 5 分钟 fallback 拉取、本地只读;credentials 仅存 MinIO、不落本地,Worker 启动时用 mc cat 直接读取;.openclaw/matrix/、.openclaw/canvas/ 是运行时临时数据、启动时重建。
存储后端支持 MinIO(私有部署)与阿里云 OSS(云原生部署),按环境变量自动适配,前缀由 ${HICLAW_STORAGE_PREFIX} 动态决定。
同步走"写方负责推送 + 事件触发拉取 + fallback 定时同步"的混合机制,核心原则一句话:谁修改谁推送,修改后通知对方拉取。OpenClaw Worker 的 hiclaw-sync.sh 在收到更新通知时手动执行;CoPaw Worker 的 sync_loop 每 5 分钟拉取 Manager 管理的文件,push_loop 每 5 秒检查本地变更自动推送。同步时排除 .openclaw/matrix/**、.openclaw/canvas/**、credentials/**、.cache/**、*.lock。
设计意图:两组严格分层。持久化的归 MinIO/OSS,运行时的归容器本地;Worker 改 Worker 的,Manager 改 Manager 的,互不覆盖。这是零信任安全在文件层的落地,也是 Worker 能做到"销毁重建不丢数据"的前提。
值得留意的是这套机制的节奏参数:5 秒推送检测、5 分钟 fallback 拉取。对以分钟到小时为粒度的任务,这个节奏是宽裕的;对高频写入的场景,它就是天花板。选哪种场景,是使用者的事。
6. 心跳与定时调度:15 分钟心跳与双 cron
心跳是 OpenClaw 内置的定时任务,默认 */15 * * * *,由运行时的 cron 调度器执行。执行前提是 Worker 工作区根目录存在非空的 HEARTBEAT.md。
不同角色的 HEARTBEAT.md 差异明确:Manager 必须有,做全局巡检(有限任务进度、团队委托任务、无限任务超时、项目进度、Worker 容量评估与容器生命周期、异常告警);Team Leader 必须有,做团队级巡检(读 team-state.json、检查子任务进度、无响应 Worker 检测、阻塞上报);普通 Worker 可选,默认不存在。
调度是双 cron 架构:系统级 cron 内置在运行时里,不可修改,负责心跳(15 分钟)与配置同步(5 分钟);用户级 cron 存在 ~/.openclaw/cron/jobs.json,支持标准 cron 表达式、时区、启用禁用。
心跳与无限任务的交互值得细看。心跳执行时遍历所有无限任务,满足"本周期内未执行过(last_executed_at < next_scheduled_at)或从未执行过"且"当前时间已超过 next_scheduled_at + 30 分钟"就触发。这 30 分钟缓冲是为了避开 Worker 繁忙时的重复触发,给任务留出执行窗口。触发后调用 lifecycle-worker.sh --action ensure-ready 确保容器就绪——返回 status=started 等 30 秒、status=recreated 等 60 秒、status=failed 则跳过并上报管理员。
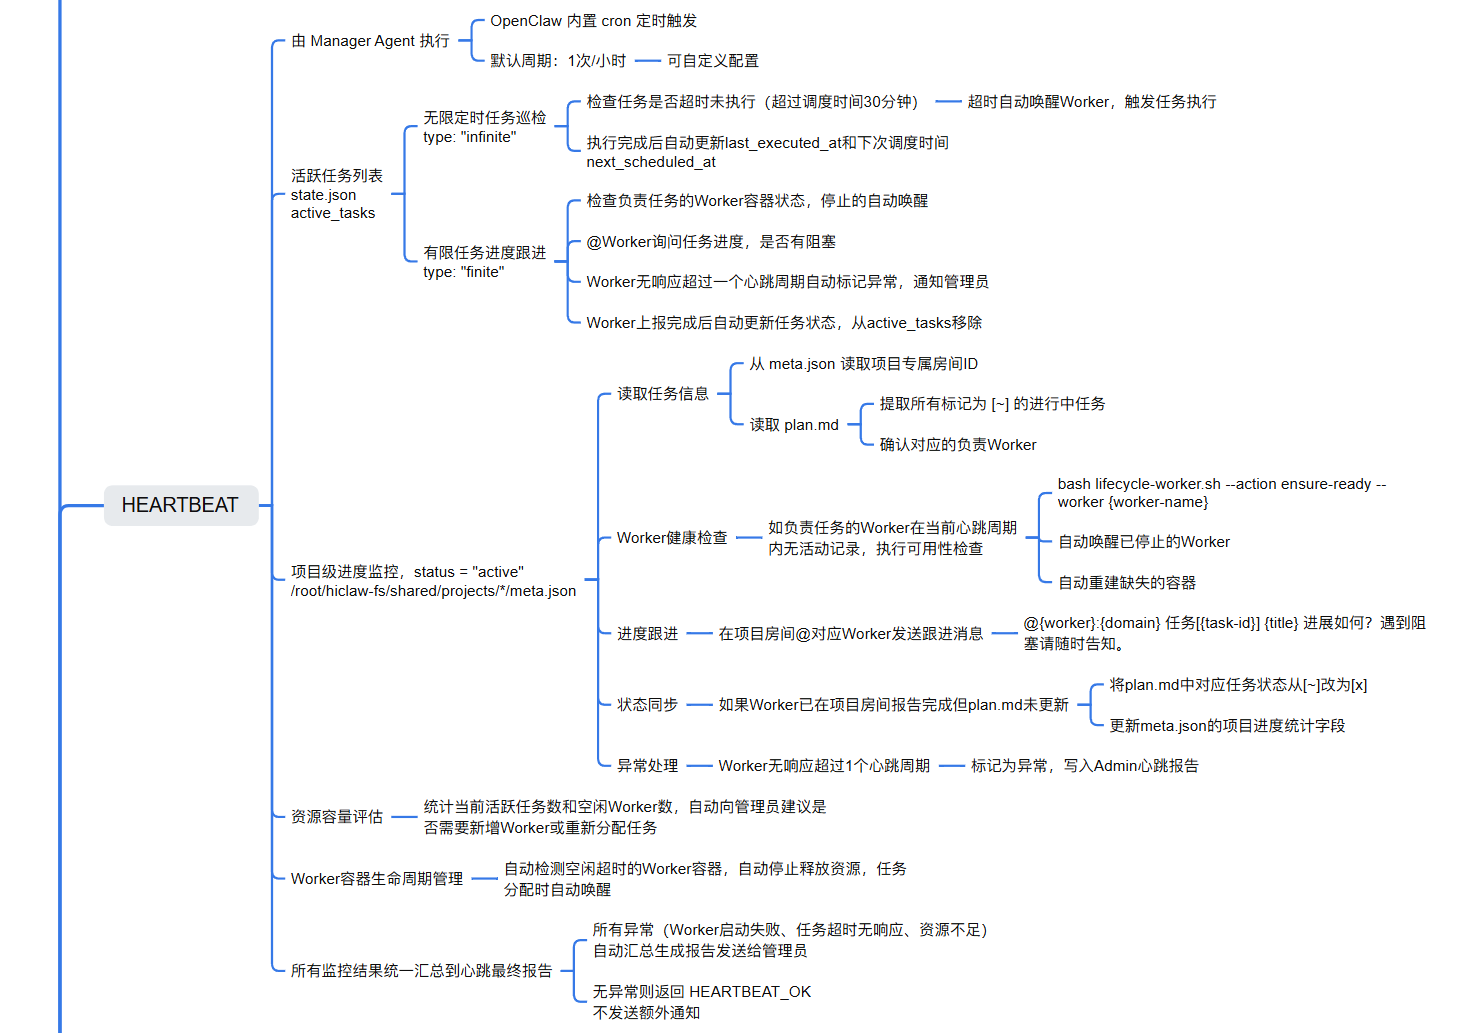
一条关键约束写得非常明确:任务完成后禁止立即 @mention Worker 触发下一次执行,必须等下一次心跳调度。理由是避免循环执行消耗 token。这是个对成本有清醒认知的设计——这道闸门一旦放开,Agent 会陷入自我触发的死循环。
设计意图:双 cron 把"系统级不可改"和"用户级可定制"分开——系统级保底线(心跳保证不漏检),用户级留空间(业务定时任务)。30 分钟窗口是对 AI 执行时长不确定性的妥协:既不卡死等结果,也不放任重复触发。
代价也一并说清:15 分钟的心跳粒度,决定了这套调度模型的自动巡检响应是分钟级的。要秒级响应的交互,得靠群聊里的 @mention 直接触发,而不是靠心跳。
7. 技能系统:SKILL.md 与加载机制
技能是 OpenClaw 的原生概念,Hiclaw 把它用得很重——前面出现的 file-sync、task-progress、team-task-management、worker-management、project-management 都是技能。
全局内置技能在 /opt/hiclaw/agent/skills/,按功能分类(file-sync-management、git-delegation-management、project-management、task-management、team-management、worker-management);Worker 自定义技能在自身工作区的 skills/ 下。每个技能是独立目录,含 SKILL.md(必选)、scripts/、references/。加载机制是启动时全量加载工作区技能,运行时动态热加载——装新技能后自动检测变更、300ms 内生效、无需重启。
SKILL.md 的格式是 YAML 前置元数据 + Markdown 正文:
---
name: 技能英文名称(唯一标识)
description: 技能功能简短描述
---
# 技能中文名称
## 功能说明
## 触发条件
## 调用方式
## 执行流程
## 注意事项
其中 name、description、功能说明、触发条件、调用方式 是必选。
技能生态的公共 registry 是 https://skills.sh/,支持从 GitHub 仓库直接安装:find-skills 技能执行 skills find <关键词> 搜索,skills add <owner/repo@skill-name> -g -y 安装,-g 是全局安装、自动同步到所有 Worker。企业部署可通过 SKILLS_API_URL 指向私有 registry。
安装的技能都过 skill-vetter 安全审查——静态扫描敏感操作、检查权限是否超出声明、匹配恶意代码特征库、高风险操作人工审核;风险分级处理:低风险自动通过、中风险提示确认、高风险拦截告警。技能运行在 Worker 的隔离容器里,即使有恶意代码也扩散不到 Manager 和其他 Worker。
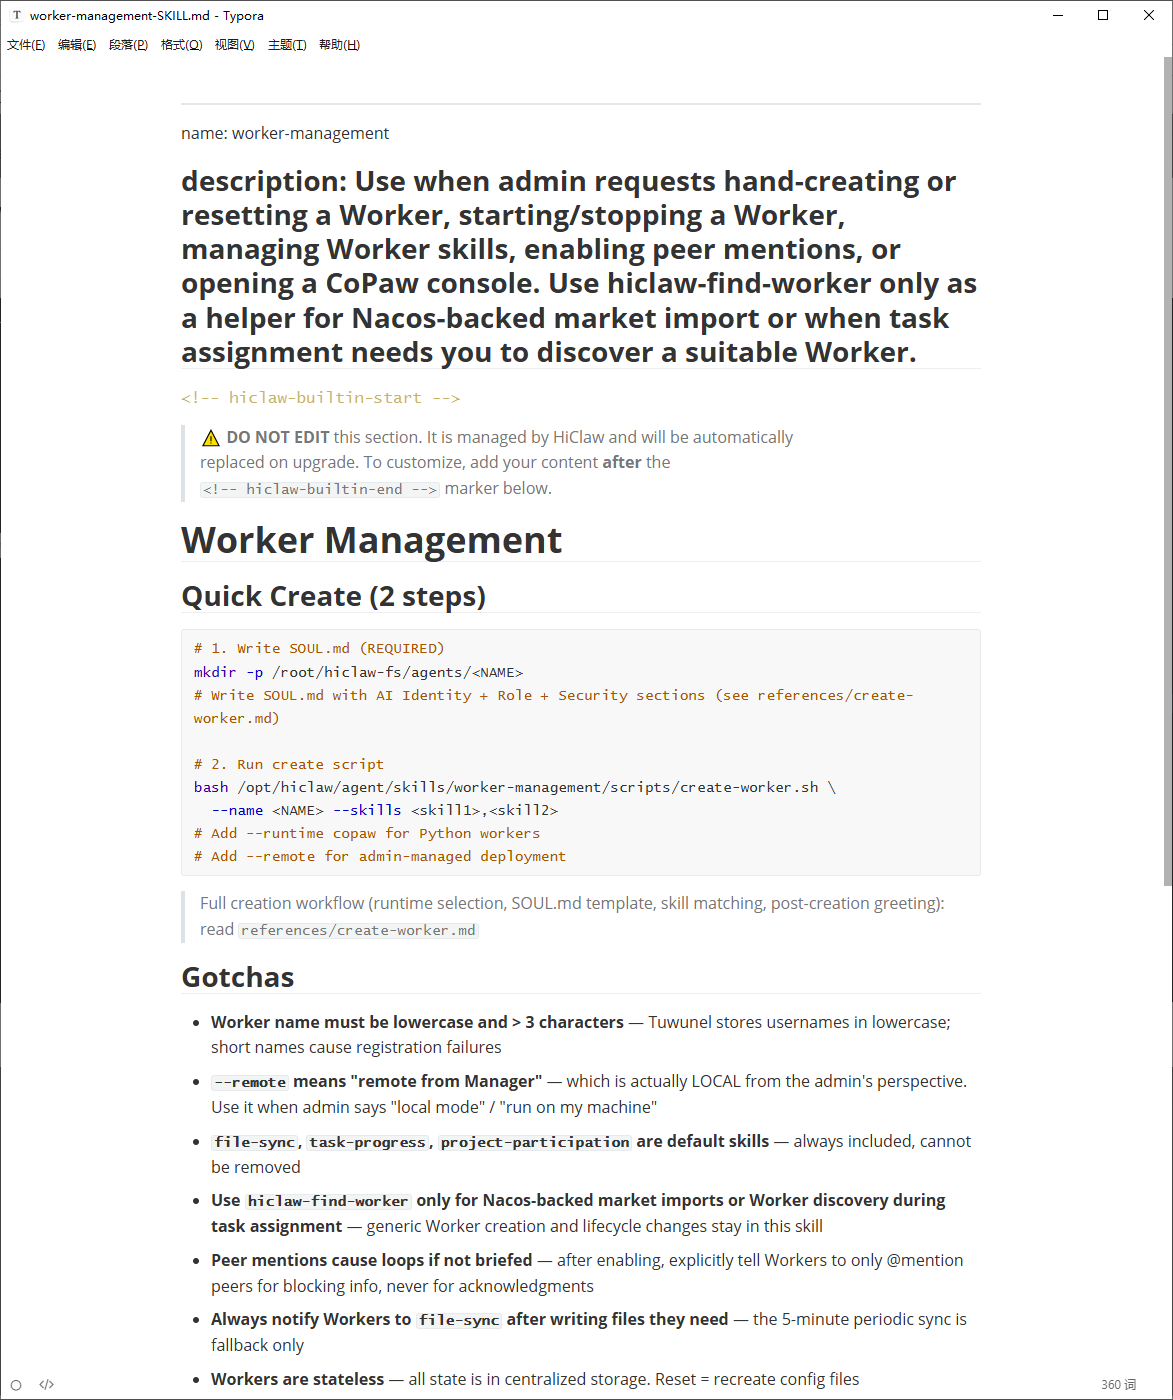
设计意图:把"Agent 能做什么"和"Agent 是谁"解耦——SOUL.md 定义身份,skills 定义能力。能力可插拔、可热加载、可共享、可审查。这是把 OpenClaw 的技能生态直接抬到了多 Agent 编排层复用,一分不多造。
二、运行原理:一套"以文件为中心"的编排
上面 7 节里反复出现"md 文件""json 文件""文件同步"。集中起来看,Hiclaw 的运行原理可以被一句话概括:
项目管理、任务管理、团队管理、状态流转,全部落在 markdown 和 json 文件上;这些文件由 Manager 和各 Worker 的工作区分别维护,靠 MinIO 做中心存储、靠推送通知与定时轮询保持一致。
这套选择的好处非常实在:
部署门槛极低——不引入数据库、不引入消息队列、不引入锁服务,一套对象存储加一堆 shell 就跑起来了
事实即文档——
plan.md既是状态数据源又是人类可读的项目叙事,meta.json既是结构化事实又是 Manager 的调度依据,不需要另外做一套看板可审计、可手改——出问题时你能直接
cat出当前状态,这在 Agent 系统里是稀缺的可观测性朴素的工程美学——
jq + mv做原子操作,shell 做状态机接口,cron 做调度
而它的边界,也就长在同一个地方。整个编排层的语义分成两半:一半是结构化事实(state.json、meta.json、workers-registry.json、team-state.json),这一半有脚本约束、有原子写入、有校验;另一半是自然语言指令(AGENTS.md 的工作流规则、plan.md 里的 return to / reassign to、SKILL.md 的"触发条件"),这一半的执行者是 AI。
对第二半,我在自己 4 月底那版纸面推演里已经吃过一次亏——当时把整条流程的状态记在几个 Markdown 文件里,让 AI 自己读、自己写、自己维护,结果像是让考生自己批改卷子。
由此得到过一个判断:md 文件做"记忆"可以,做"状态"要谨慎——记忆允许模糊,状态需要精确。
Hiclaw 显然比我那版推演严谨得多:它给状态写操作加了原子脚本,给一致性加了心跳巡检,给项目和任务加了双文件互校。所以我的那点顾虑在这套实现下会不会被消化掉,我现在没有结论,只能列出三个还想继续观察的点:
多工作区的副本一致性。同一份
state.json在 Manager 和每个 Worker 的本地都有副本,"谁修改谁推送、改完通知对方拉取"是清晰的约定,但约定的落地依赖推送不漏、通知不丢,兜底是 5 分钟的 fallback 拉取。任务密集时这个窗口够不够,取决于并发密度。状态转移由谁执行。
plan.md的[ ]/[~]/[x]/[!]/[→]和修订指令是写给 Worker 看的,Worker 读完自己决定下一步。这等于把状态转移的执行交给一个概率预测器——心跳巡检会做一致性校验并告警,但告警是事后的,且对象是管理员。Team Leader 做路由网关的容错。层次化调度把 Manager 的压力分流了,代价是把路由的关键路径压在一个同样是容器的 Worker 上。我自己那版设计里也想过让一个 Team Leader 专职做路由网关,纸面推到这一步就卡住了:它挂掉之后谁来接手,我没有想出答案。
这三点都不是"结论",是接下来要靠实际跑量去验证的清单。
三、评价与反思
Hiclaw 值得肯定的地方,得先摆足。
第一是组件选型。Higress 做流量入口与 AI 网关、MinIO/OSS 做存储后端、Matrix 协议 + Element 客户端做 IM 通信、OpenClaw 做单个 Agent 的运行时——每个组件都选在"开源 + 企业可私有化 + 替换成本低"的交集上。这是一份对"私有化部署"场景做过深度思考的清单,不是把开源组件拍脑袋拼起来的产物。
第二是零信任设计。Worker 不持真实 API 凭证,凭证由 Higress AI 网关集中管理——这一条把"Agent 安全"从"希望它不出事"升级成"假定它会出事、出了事也不致命"。credentials 目录仅存 MinIO、不落本地、启动时 mc cat 直接读取,技能系统的 skill-vetter 审查 + 风险分级 + 隔离容器,都是同一套思路在不同层的落地。这种细节处理很见功底。
第三是把"IM 群聊"做成人类介入通道。Matrix 群聊供人类实时旁观与插话,Manager/Admin 权限等级 100、Worker 为 0,项目群自动邀请管理员和全部 Worker——权限边界划得很清,"人类介入"也从一个理论概念变成了可操作的日常工作流。这一点,是我认为 Hiclaw 相比"给你一个黑盒专家团"的方案最有价值的地方。
第四是把 OpenClaw 的技能生态直接复用。SKILL.md 格式、热加载、公共与私有 registry、安全审查——这套生态不是 Hiclaw 从零做的,但它用得非常彻底。这种"不重复造轮子"的克制,在开源协作里是稀缺美德。
那么它的取舍在哪儿?就在前面反复出现的两个词里——"提示词"和"文件"。
编排层(Manager 怎么调度 Worker)押在提示词上;状态层(任务、项目、团队进度)押在文件上。这两句话不是批评,它们同时是 Hiclaw 部署门槛低的根本原因,也是它在规模化场景下需要被验证的地方。任何架构都是在约束下的取舍——在"零依赖、低门槛、可私有化"这三条约束下,把状态放进文件、把编排交给提示词,是相当合理的解法。
至于 manager-workers 这个模式本身的适用边界,拆完源码后我的判断是:它适合 Agent 数量在个位数到十几个、任务以分钟到小时为粒度、人类可以随时在群聊里介入纠偏的场景。再往上走——几十个 Agent、秒级流转、强一致的状态要求——这套方案会开始吃力,但那已经不是它当前的目标场景了。
官方最近一次版本升级做了一轮底层重构,把原本和 Manager 挤在一起的基础组件剥离到独立容器、调整了文件同步方式与 Worker 生命周期、让 Agent 的"记忆"不再那么关键、每类 Worker 更偏向特定方向的专家任务、上下文尽可能干净。方向是对的——剥离为了解耦,解耦为了让每层能独立演进。代价是使用者得跟着升级踩坑,这是所有早期项目共同的税。
四、结尾
拆完这 7 个模块,最大的收获不是"Hiclaw 怎么用",而是看清了一个多 Agent 编排系统必须回答的几个问题:Agent 的身份和能力怎么分离、状态放在哪里、谁有权改它、状态转移由谁执行、人类从哪里介入、出错之后靠什么发现。
Hiclaw 对每一个都给了答案,而且答案自洽。它把"多 Agent + 人协作"这件事从概念做成了可私有化部署的产品,这是先行者的贡献。我接下来要做的,是拿自己的研发流水线去压这些答案——尤其是"状态放在哪里"和"状态转移由谁执行"这两条。
如果实践证明文件够用,那这套朴素方案的性价比无人能敌;如果不够用,那我就得把状态从文件里搬出去、把调度权从 Agent 手里收回来,交给一个更笨但更确定的东西。
这件事我还没有答案,只有一个越来越强的直觉——
判断一个 Agent 平台能走多远,要看它的状态机是不是一个真正的状态机。
而"真正的状态机"这五个字的分量,恐怕只有把它写崩过一次的人才知道。
附:其他一些官方PPT中提到的概念架构


评论区