

读别人的方案读出来的归纳+自己真跑起来、每天都在出日志的那套定时任务。
一、记忆是 Agent 的第一性课题
"AI 总是忘记你昨天说过的话。"——这几乎是每一个把 Agent 真正用起来的人最早撞上的一堵墙。
为什么说记忆是第一性的?因为 Agent 的一切行为质量,归根到底取决于它当下能看见什么。提示词写得再漂亮,上下文里没有对应的记忆,它就只能在"这一帧"里做判断;上下文里混进了过时信息,它就会拿着错误的剧本认真演下去。上下文决定行为质量,而记忆是上下文的核心来源。
这不是观点,是大实话。光是"昨天明明告诉过你,今天怎么又忘了"这种事反复发生几次,结论自己就浮上来了。
需要先交代一句环境:手上这只 OpenClaw 不是裸跑的,它是 Hiclaw 的 Agent 运行时。所以最先要救的是那个 Manager——消息最密、决策最多、忘事代价最大的就是它,架构图上这套东西也只针对它。Worker 那边我只铺了规则和写日志的入口,没上自动化。
二、站在别人的肩膀上:三篇「拯救龙虾记忆」读完的归纳
动手之前先读了桔子在「AI Agent 新手村」写的《拯救龙虾记忆,OpenClaw 记忆系统演进系列》三篇——《搭建记忆结构的底座》《构建主被动记忆的防线》《打通记忆检索的引擎》。这三篇的演进主线,基本把这件事该走的路铺清楚了:结构 → 触发 → 检索。
这份连载值得反复咀嚼。下面是我读完之后自己归纳的三层,以及每层我认同和保留意见的地方。
2.1 第一层,结构:从"一个大文件"到"索引 + 分类"
OpenClaw 默认只把记忆分重不重要:重要的塞 MEMORY.md,不重要的看心情写进当天的 memory/YYYY-MM-DD.md。问题是重要的文件只有一个,膨胀极快,而每次任务都要把它整个加载进上下文。
原文给的拆法是两刀。第一刀按"紧不紧急"拆出 NOW.md——不重要但近期得盯着的事挪出去;第二刀按类型拆成 lessons/、decisions/、projects/、preferences/,一个文件说一件事。拆完的效果,原文列了一张对比表:
MEMORY.md大小 ~50KB → ~5KB;单次加载 token ~15K → ~3K;知识文件检索从全量扫描变成 INDEX 定向。
但这一层里真正值钱的不是分类,是那个 INDEX.md。原文点得很准——它的灵感来自 skills:
为啥装了再多 skills 也不担心上下文爆炸,这就是渐进式披露的精巧之处,先只加载功能描述和触发场景,等需要的时候再加载完整技能。
分类只是让文件变多,索引才是让文件变多之后仍然可用的那个前提。会话初始化时只加载索引,需要哪一类再取对应文件。没有这一步,把 50KB 拆成 20 个文件再全量读一遍,和原来没有区别,只是满足了整理欲。
2.2 第二层,触发:别指望 Agent 自觉
第二篇一句话把幻想打碎了:
指望龙虾自我觉知,发挥主观能动性默默地记日志,并不现实。
这句我读的时候是有共鸣的。规则写得再全,memory/YYYY-MM-DD.md 该空还是空。原文给的三道防线:
Memory Flush——OpenClaw 内置机制,会话快到压缩阈值前强制写一次日志。局限也写明了:被动触发,任务轻的时候几天都聊不满阈值,等于不触发。
心跳扫描——每 60 分钟扫一遍近一小时的 session,清洗、提纯、补录。
夜间反思——以天为单位做梳理,凌晨两个 cron,先查缺补漏生成素材,再做深度反思和知识回写。
这三道防线的共同点,是把"记"这个动作从模型的自觉里拿出来,交给周期。能被调度的机制才叫机制,靠提醒维持的不叫机制。这一层我几乎是照着思路自己实现了一遍,第四节就是成果。
2.3 第三层,检索:这一层我没自己上手
第三篇讲的是检索:Memory Core 默认不配 embedding 就会退化成纯 BM25 全文搜索,配上向量之后可以做混合检索、MMR 多样性重排、时间衰减;更进一步是换 QMD 这个 backend,独立索引、多 Collection,还能把 Obsidian 笔记库一起纳进来联合检索。
其中有一条判断我很喜欢,是讲时间衰减半衰期设 30 天的那句:
这就像我们人的记忆方式,重要的事物常记,日常流水随时间淡忘。衰减掉的是噪音,沉淀下来的是判断。
但这一层我是靠 Hiclaw 自身的机制完成的,Hiclaw 中的 Manager 只要接入向量化模型就会启用向量记忆,这个向量搜索会和检索层的起冲突,得诚实说清楚。
所以本文分享的部分,只到"落库做扎实"为止。检索层留着,是接下来要验证的清单。
三、踩坑:三类,简要说
坑不少,但真正有复用价值的就三类,其余都是这三类的变体。
第一类,配了等于没配。 记忆规则明明写好了,第二天一看当日日志是空的。排查下来三条根因,指向的是同一件事——记忆机制不能假设"它总有机会执行":
sleeping schedule 本质是"空闲时才执行的动作",Agent 一直被消息触发、会话没真正进入休眠,这条计划就永远轮不到;
心跳来了要读
HEARTBEAT.md做检查,可当前上下文已经被任务对话塞满,这一轮的处理预算就被吃掉了,轮到记忆检查往往草草了事;更隐蔽的是规则打架:记忆规则写在
AGENTS.md里,而某个 skill 自带一套相反的写文件约定,Agent 照着 skill 的新规矩写,写出来的东西记忆系统不认。
第二类,"你是谁"不能放在记忆里。 Agent 用着用着身份会漂——该做审查的开始主动写代码。根因是把自我认知这类信息放进了会随上下文滚动的记忆里。解法很直接:persona 固化在 SOUL.md / AGENTS.md 这类每次会话必读的文件里,不进 memory/。记忆管的是"发生过什么",不是"我是谁",后者必须每次都准、都不变。
第三类,任务状态和记忆混在一起。 表现是任务标记完成了,残留状态还在活跃列表里晃,Agent 时不时还在"处理"一个早该结束的任务,甚至把它的状态写进记忆污染上下文;同时还有一件事很费人——Agent 之间的 @ 提醒经常唤不醒对方,最后得手动去 @ 那个该接手的,人成了中转站。这一类的根因当时没扒清楚,但有一条判断留下来了:记忆和任务是两套东西,别共用一套文件。
三类合起来,教训只有一句:Agent 会忘、会被打断、会被别的规则带跑,所以记忆写入必须走确定性的路径。这句话就是下一节那套脚本的全部动机。
四、真正跑通的部分:四个定时任务 + 两个小工具
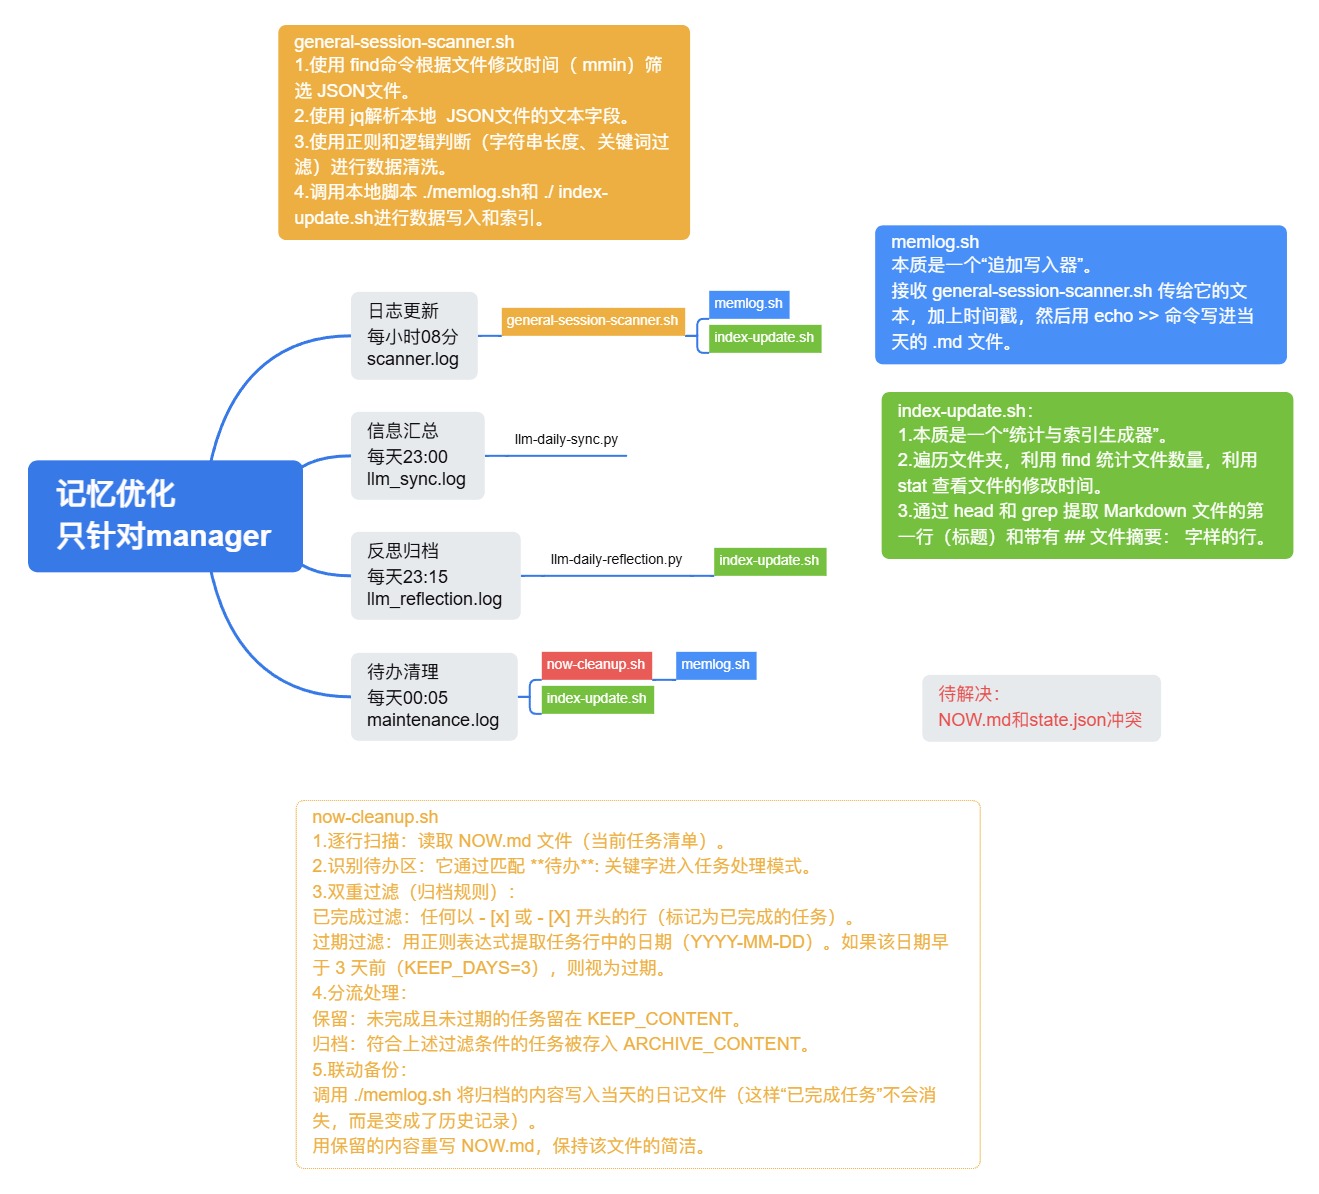
整体是四条定时分支,每条都有自己的日志文件:
底下两个被反复调用的小工具是 memlog.sh 和 index-update.sh。整套东西的分工可以用一句话概括:脚本负责结构与确定性,模型只负责语义。
4.1 memlog.sh:唯一的写入口
它本质就是个追加写入器——接一个标题、一段正文,加时间戳,追加进当天的 .md:
memlog.sh "任务完成" "正文内容"
# 追加到 memory/2026-04-08.md
### 14:16 — 任务完成
正文内容功能简单,但它是整套规则的地基,因为配套的一条硬规则是:禁止手动修改 YYYY-MM-DD.md,所有日志必须走 memlog.sh。写入口只有一个,格式才能统一,后面的解析和索引才有前提。
里面有两个小设计是踩出来的。一个是默认做重复检查:同标题的记录已存在就跳过,需要重复写得显式加 -f——因为补录脚本和 Agent 自己的主动记录会撞车。另一个是只追加、绝不覆盖,echo >> 而不是重写文件。记忆是只增不减的账本,要改就在末尾补说明,不抹历史。
4.2 general-session-scanner.sh:每小时补一次漏
这条对应上面第二层的"心跳扫描"。逻辑不复杂,但每一步都是在跟噪音搏斗:
find按修改时间(-mmin)筛出最近 N 分钟动过的会话 JSON;jq解析,只留user和assistant两个角色的文本,thinking 和工具调用全部丢掉;清洗:空内容、
HEARTBEAT_OK、NO_REPLY、纯<think>段、"好的/收到/继续/撤销/没问题"这类应答、以及长度不足 5 个字符的,一律过滤;超过 360 字符的截断,留个"内容过长已截断"的标记;
剩下的交给
memlog.sh落盘,最后调index-update.sh刷索引。
写这段时最花时间的不是 find 和 jq,是第 3 步的过滤规则。心跳补录的价值高低,完全取决于噪音过滤做得有多狠——不过滤的话,补录出来的日志里一半是"收到"和心跳应答,看着热闹,第二天回读一点用没有,反而把真正的信息稀释了。
调用时传分钟数(general-session-scanner.sh 60),和心跳周期对齐。60 分钟是个折中:更短会频繁打扰主会话,更长则漏得多。
4.3 夜里那两步:先对账,再反思
这是整套里唯一让模型参与的环节,也是我最舍不得的部分。拆成两个脚本、隔 15 分钟跑,是故意的。
23:00,llm-daily-sync.py 只做一件事:对账。 它把当天所有有效会话(跳过 .reset. / .deleted. 这类无效文件)解析成纯文本,和当天已有的日志一起丢给模型,让它交叉比对,输出一份"反思预备素材":遗漏补充内容、关键时间线、未完成/阻塞事项、下一步动作。
这一步有条铁律写在脚本里也写在规则里:绝对不修改原始当日日志。补漏的结果单独落一个 YYYY-MM-DD-reflection-prep.md 中间产物。原因很简单——原始日志是事实层,模型是可能出错的一层,不能让一个会出错的环节去改写事实。素材长度也做了硬截断,防止塞爆上下文。
23:15,llm-daily-reflection.py 才做反思和知识回写。 输入是"当日日志 + 预备素材",输出两部分:一份结构化的深度反思落进 reflections/,以及按路由规则回写到 lessons/、decisions/、projects/ 的知识条目。
这个脚本里有几个点是反复调出来的:
要求模型输出固定的三段式结构:
【标题】/【摘要】/【内容】。摘要不是给人看的,是给index-update.sh用grep抓出来做索引的。让模型产出结构化字段,索引就能退化成纯文本处理,不需要再喂一次模型。temperature=0.1+ 空内容拦截 + 重试。生成内容为空、字段不全、正则匹配不到条目,一律中止写入而不是写个半成品进去。宁可今天没有反思,也不能让脏数据进账本。写文件前自动备份,备份名带秒级时间戳。
去重校验:写
lessons/前先读原文件,内容已存在就跳过;新文件自动补标准头部(标题 + 文件摘要),已有文件按日期追加一段。decisions/的文件名带日期,因为决策是一次性事件;projects/和lessons/用主题名,因为它们要长期追加。
模型选的是便宜的长上下文那一档——这个环节要的是"读得完、别漏",不是"想得深",把预算花在上下文长度上比花在推理能力上划算。跑的时间点定在 23:00 和 23:15 而不是凌晨,纯粹是想在睡前能看一眼日志确认它没崩。
4.4 now-cleanup.sh:让待办自己降解
NOW.md 是唯一允许全量覆写的记忆文件,因为它记的是"当前状态",天生要滚动。每天 00:05 跑一次清理:
逐行读
NOW.md,靠**待办**:关键字进入待办区处理模式,区块外的内容原样保留;双重过滤:
- [x]开头的已完成项,以及正则提取出日期、早于 3 天前的过期项;命中的进归档,没命中的留下;
归档不是删除——归档内容调
memlog.sh写进当天日志,已完成的任务变成历史记录;原文件备份到专用目录,再用保留内容重写
NOW.md。
顺手加了个小东西:文件头那行"YYYY-MM-DD HH:MM 更新"的时间戳自动刷新。这纯属强迫症,但看到时间戳是今天的,才确认这套东西还活着。
KEEP_DAYS=3 这个值和"近 3 天优先级"的规则是对齐的。清理规则和记忆规则必须说同一句话,否则脚本清掉的正是规则要求 Agent 关注的。
4.5 index-update.sh:把索引变成统计产物
INDEX.md 不是手写的,是算出来的。它遍历四个分类目录,find 数文件、stat 取修改时间,head -n1 取标题、grep 抓那行 ## 文件摘要:,拼出一份带健康度概览的索引:总文件数、超过 30 天没动的过时文件数、每个分类下的文件列表(按时间倒序,过时的前面挂 ⚠️)。
配套规则同样是禁止手改,写之前照例备份旧版本。
这个脚本让 INDEX.md 从"一份需要维护的文档"变成"一份随时可重新生成的产物"——可重新生成的东西才不会腐烂。它同时也是记忆系统的观测窗口:和它聊记忆相关的问题时,先看索引,需要哪块再加载哪块。没有这个窗口,记忆系统会悄悄烂掉,等发现的时候已经污染了一堆上下文。
4.6 规则怎么和脚本咬合
脚本只解决"能做",规则解决"必须这么做"。规则我写在 AGENTS.md 的自定义区,位置有讲究——加在 <!-- hiclaw-builtin-end --> 标记之后,因为标记之内的区域会在版本升级时被系统覆盖。开头声明与内置规则冲突时以本节为准,其余部分只做扩展不做替换。扩展别人的系统时,改动位置的选择比改动内容更能决定这套东西能活多久。
核心几条:
路径简写:所有
memory/下的引用省略前缀,decisions/xxx.md就是memory/decisions/xxx.md。省的是每次加载的 token。每会话初始化附加两个文件:
NOW.md拿当前待办,INDEX.md拿索引,需要具体内容再按需加载。写入校验:写知识类文件前先读原有内容做增删改查判断,确认无重复或冲突再写。
只追加:除
NOW.md外全部追加模式。记忆路由:可复用的踩坑及具体解法(含命令、配置、验证结果)→
lessons/;影响后续方向的决策 →decisions/;项目状态变更 →projects/;用户偏好 →preferences/;其余日常 → 当日流水账;不属于以上的深度分析类内容 → Obsidian 外部笔记。内外分工:万字报告、教程、周月复盘、选型对比这类大体积内容一律进 Obsidian,判定标准一句话——这条内容未来会不会被直接引用来解决问题? 会的留内部记忆,分析类的挪出去。这条边界划清之后,
MEMORY.md的 5KB 上限才守得住。
五、还没想清楚的部分
写完这套,反而有几个问题更清楚地浮出来了。
最扎手的一条:NOW.md 和 state.json 在打架。 一个是我这套记忆系统里的待办清单,一个是平台自己维护的任务状态。它们描述的是同一批事,但更新机制、生命周期、权威性都不一样。清理脚本按 3 天窗口归档 NOW.md 的待办,可任务状态那边并不认这个窗口。目前的做法是让它们各管一头、不互相同步,但这明显只是权宜之计,架构图上我就直接标了"待解决"。
顺着这条往下想,有个更根本的疑问还悬着:记忆是允许模糊的——记错一句话、漏一个细节,代价不大;但那些需要精确的东西,放在同一套 md 文件里合适吗? 这个问题我现在没有答案,只有一点不安。
还有一条正在成形的直觉,和记忆本身关系不大,但是调这套东西的时候越调越强:多个各管一摊的 Agent,可能确实比一个什么都干的 Agent 更可靠。理由都是很朴素的观察——上下文更干净、更容易停在模型推理不掉档的那个区间、总 token 花得更不浪费、skill 装少了也不会互相打架。至于多个 Agent 之间怎么协作才不乱,这套记忆系统回答不了。
最后一条是展望,也是当时最没底的一条。现在这套东西解决的是"该记的能不能稳定记下来、按需取出来",但它本质上还是"把知识塞进文件、需要时加载进上下文"。人不是这么记事的——人记得的是"有这么个东西,需要时去查"。所以想往 LLM Wiki 那个方向走一走:让 AI 像人一样查资料、整理知识,而不是把一切都背在上下文里。Obsidian 外部存储算是这一层很初级的雏形,但它只是"把文件挪到了外面",离"会主动查、会整理、会交叉引用"差得远。怎么落地?没答案。所以只放在展望里,不进方法论。
六、结尾
回头看,这次折腾产出的其实不是一套多聪明的设计,而是一条很笨的原则:把该记住的事情,从模型的自觉里拿出来,交给能被调度、能被观测、能被重新生成的东西。四条定时任务、两个小工具、一份写在升级不会被覆盖的位置的规则,全都是这条原则的具体形态。
也 要承认这套东西的天花板很明显:落库做扎实了,检索还是原样;记忆和任务状态的边界还在打架;规则条数已经多到需要一份索引来管索引。它现在够用,规模再上一个量级还撑不撑得住,我不知道。
带着这些,接下来想试着往前走一步——不只是让一个 Agent 记得住事,而是让一群分工明确的 Agent 把一件事按流程做完。这篇里那些"写入必须走脚本""记忆和任务要分离"的判断,都会在那件事里被重新检验一遍。具体写成什么样,见后续文章。
记忆系统的目标从来不是"记得多",而是"该出现的时候出现、不该出现的时候别挡路"。
参考与致谢:桔子《拯救龙虾记忆,OpenClaw 记忆系统演进系列》,发表于「AI Agent 新手村」。本文第二节是我读完这三篇之后的归纳与取舍,分层结构、心跳补录、夜间反思这三条主线均受其启发,具体实现与规则设计为自己重写。
评论区